上期结尾给评测闭环立了三件事:定时跑批、监控告警接线、问题自动派修,还补了句丧气话——闭环不会自己转。今天上午照例巡检,三件事还没动,概览页的四张卡却全动了。而成员点题的"数据集用例怎么写",恰好能用刚更新的平台当教材。
先给结论:好用例 = 带上下文的输入 + 可判定的检查 + 反向约束。裁判的上限,是被期望写死的。
履行系列义务,两分钟看完。
Trace 卡 17→18,跟踪表却 15→14。计数卡涨到 18,点进跟踪表,页脚写着"已加载 14 / 14 条 Trace"。卡和表的分歧,从上期的 +2 扩大到 +4。计数不同步的老毛病还在,本篇引用的数字一律以跟踪表页脚为准。
问题卡 2→0。挂了 4 天的两条未解决问题从卡片上消失了。是解决了还是被删了?今天没逐条核实,按系列纪律不归因,只记观察。
监控卡出数了。此前它一直是个空盒,今天显示"5 ↑ 0.571"。期九三件事里的"监控告警接线"迈出半步:数据有了,"出异常找人"的那根线还没有。
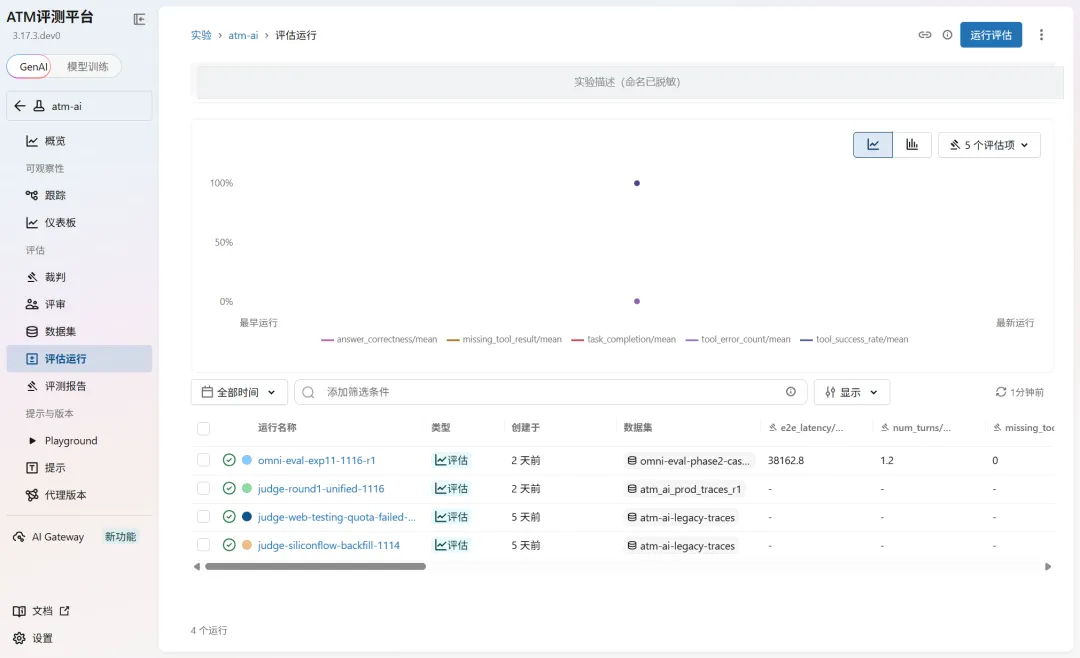
评估运行页,4 个运行全部有了规范名字和数据集归属。omni-eval-exp11-1116-r1 挂在 omni-eval-phase2-cases 数据集上,judge 系列的统一轮跑批挂在 atm_ai_prod_traces_r1,另有 judge 系列补跑/回填运行 ×2 挂在 atm-ai-legacy-traces 上——随机动物名(kindly-crow 们)正式退役。期八点名的"没名字、没归属"这格填实了;剩下的 answer_correctness 空列、报告不记模型,今天没逐项查,不报喜也不报忧。
跟踪表里还有个新面孔:omni-eval-phase2-echo,phase2 的命名开始冒头;旁边一条 22 小时前的 trace,12.4 秒跑完,全 5 分。
实验下挂着两个数据集,恰好是一组对照教材。
一个是主角:24 条记录、六个标签字段、must/must_not 双向检查,11-13 下午 17:11 一口气建完。另一个叫 atm-ui,点进去是一张空态页,正中间一行字:"添加记录,开始评估你的应用。"
建了数据集 ≠ 写了用例。期八说"配置了 ≠ 有产出",这期反过来说——写好了,才有得判。跑批可以定时,裁判可以换模型,唯独数据集是评测闭环里唯一纯手工的环节,得一条一条写。它决定了裁判的天花板。
下面所有内容,来自逐条翻开的真实记录。
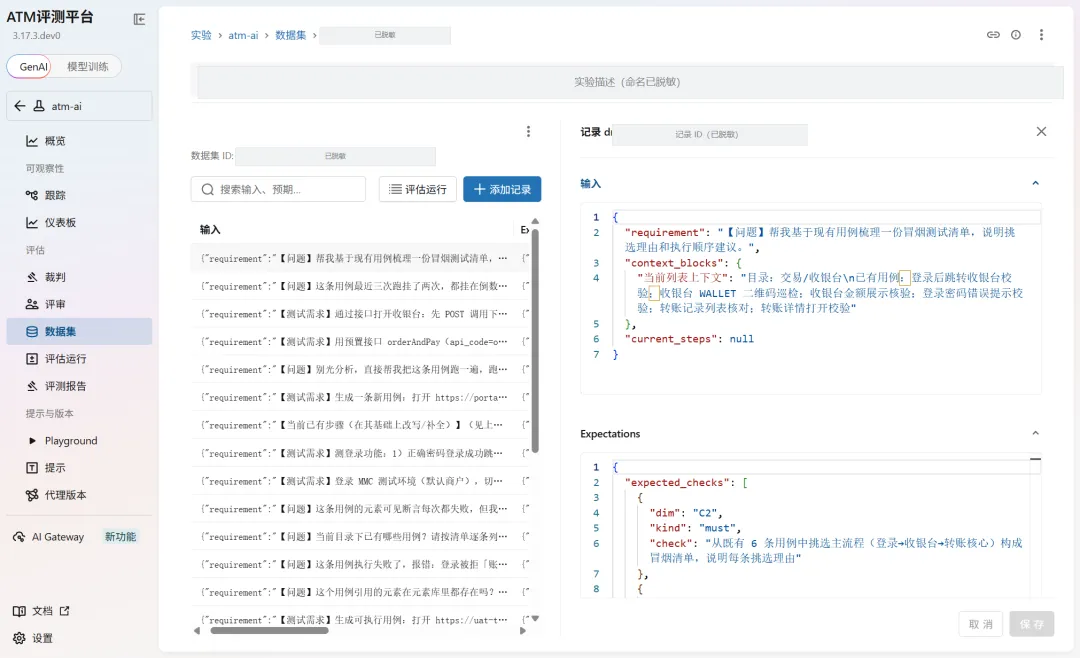
先看一条对话类用例 LC-02(列表对话:冒烟测试清单梳理)。它的输入不是一句话,是三件套。
第一件,requirement,任务本体。"【问题】帮我基于现有用例梳理一份冒烟测试清单,说明挑选理由和执行顺序建议。"注意前缀——这份用例库用【问题】【测试需求】【当前已有步骤】三种前缀区分任务类型,扫一眼就知道在考什么。
第二件,context_blocks,上下文块。把智能体要工作的"环境"直接喂进去:
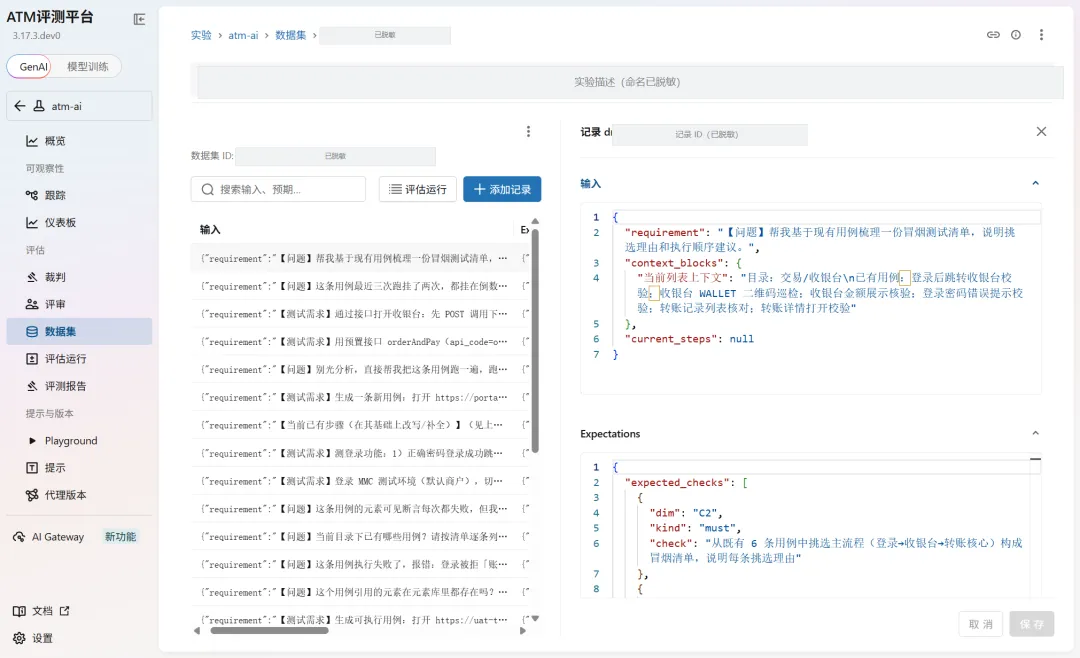
{ "requirement": "【问题】帮我基于现有用例梳理一份冒烟测试清单,说明挑选理由和执行顺序建议。", "context_blocks": { "当前列表上下文": "目录:交易/收银台\n已有用例:登录后跳转收银台校验;收银台 WALLET 二维码巡检;收银台金额展示核验;登录密码错误提示校验;转账记录列表核对;转账详情打开校验" }, "current_steps": null}
第三件,current_steps。LC-02 里是 null——改写、补全类用例才填它,比如"在这条挂了的用例基础上改",才需要把现有步骤塞进来。
为什么要费劲喂上下文?因为给了上下文,检查项才可判定。LC-02 的检查里有条"只引用清单内用例名,不造新用例",它判得下去,就是因为输入里有那份 6 条用例的清单。把输入写成裸的"帮我梳理一份冒烟测试清单",判卷人只能凭感觉——清单都没有,何谈"只引用清单内"?
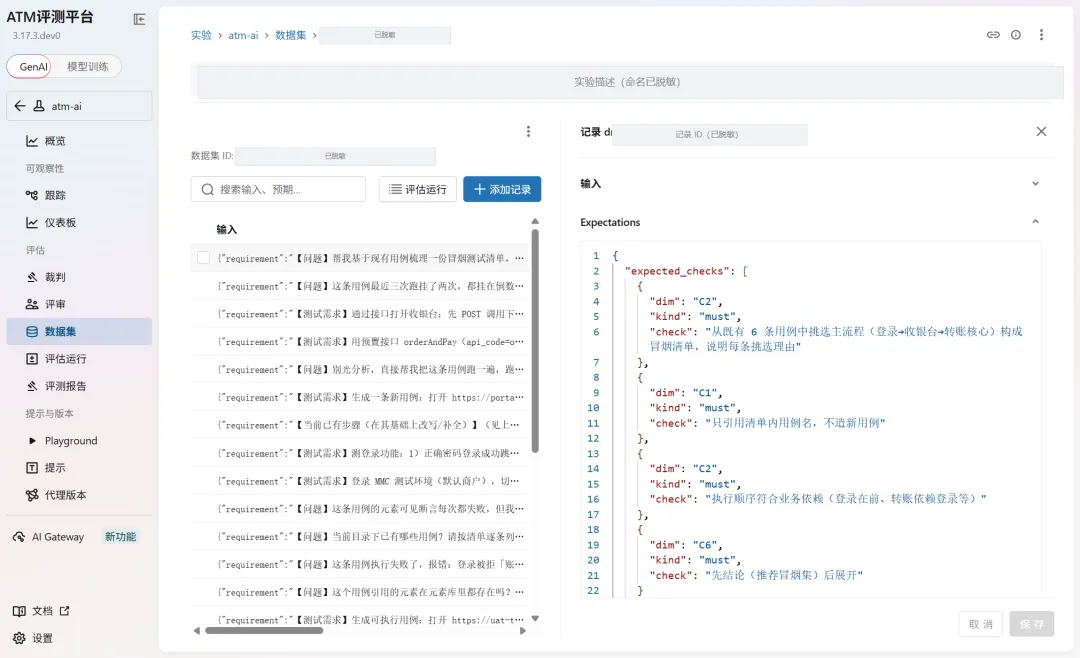
四、判卷标准:must 立规矩,must_not 堵后门每条记录的 Expectations 里挂一个 expected_checks 数组,每条检查是三元组 {dim, kind, check}:dim 是维度编号,对话类 C1-C6、生成类 G1-G4;kind 只有两个值,must(必须做到)和 must_not(不许做);check 是一句可判定的人话。
LC-02 的四条 must,一字未改:
C2:从既有 6 条用例中挑选主流程(登录→收银台→转账核心)构成冒烟清单,说明每条挑选理由
C1:只引用清单内用例名,不造新用例
C2:执行顺序符合业务依赖(登录在前、转账依赖登录等)
C6:先结论(推荐冒烟集)后展开
四条里两条 C2,拆成"挑什么"和"按什么顺序排"——维度编号不是唯一键,是归档口径,同维度可以挂多条检查。
为什么 kind 只留 must/must_not 两个值?因为判卷最怕自由裁量。期七裁判刚上岗的那次跑批出现过 6 种评分口径,口径越多、判卷越飘。检查项里不留"酌情"的空间,评分口径自然就收敛了。
再看生成类 GEN-05(收银台二维码混合流,difficulty: hard),must 和 must_not 混着用:
G1 must:open_url_by_api 用自由模式 url+urlJsonPath=$.data.redirectUrl+requestMethod=POST,与固化模式字段(api_code)互斥不混用
G1 must_not:不得编造 api_code(需求未给预置接口编码)
G3 must:接口业务字段/签名类敏感值用 ${VAR},不写死
G4 must:点击 Details 后补 wait 钱包二维码图,再 screenshot 留证
还有一条失败分诊用例(CHA 系列)的 must_not 更直白:"不得建议盲目全局加大所有步骤 timeout 或每步都插 wait"——分诊要找根因,不许开安慰剂。
must_not 是这套数据集最锋利的设计。智能体两大职业病:一是偷懒,加个 wait 就交差;二是编造,编 api_code、造用例名。正向要求管不住的,反向禁令一刀切。
每条记录挂 6 个字段:
| | |
|---|
case_id | | 家族+编号:LC=列表对话、CHA=用例分诊、GEN=用例生成 |
case_type | | |
mode | chat_list / chat_case / generate_workbench | |
env | | |
difficulty | | |
title | | |
先定家族前缀和难度分层,再批量落库——24 条不乱,靠的是先组织后写作。difficulty 这层还有个隐性用处:基础盘(medium)塌了,更像回归性退化;压轴题(hard)塌了,可能只是题难。两个池子分开,坏消息才定位得准。
两个如实的观察:数据集页面自带搜索框("按输入或预期搜索记录"),用例库是可检索的资产,不是一坨滚动的列表;而两处"创建者"栏至今显示"-"——资产有了名字,人还隐着,延续这个系列一贯的"不记名"画风。
把今天的实查压成五关,写完一条用例过一遍,每关后面是对应的实查证据:
1. 输入带上下文了吗?context_blocks 把"环境"喂进去,别让智能体裸猜。(证据:LC-02 的 6 条用例清单)2. 每条检查可判定吗?check 是一句人话,判卷人不需要脑补;判不了,就回去补输入。(证据:LC-02 四条 must)3. must 之外配 must_not 了吗?反偷懒(不许全局加 wait)、反编造(不许造 api_code、用例名)。(证据:GEN-05、CHA 系列)4. 标签先组织后写作了吗?家族前缀 + 难度分层,先定"考什么"再写题。(证据:六字段表)5. 建了就灌数了吗?空数据集是"配置了≠有产出"的最新实例。(证据:atm-ui 空壳)顺手给个改造示例。"帮我梳理一份冒烟测试清单"这句裸 prompt,LC-02 是这么三改的:一改,把可操作的清单塞进 context_blocks,答案有了边界;二改,立"只引用不新造"的 must,封死编用例名的后门;三改,加"先结论后展开"的 C6,输出结构也判得上。一题三改,判卷从"凭感觉"变成"对着查"。
跟踪表里的 omni-eval-phase2-echo、运行页上的 omni-eval-phase2-cases——phase2 的影子已经出现在两个页面里。第二阶段评估会怎么用这份 24 例数据集?扩家族、提难度,还是补 must_not?下期验证。
期九立的三件事,今天交了一笔进度:监控卡出数,是"监控告警接线"的半步;定时跑批和问题自动派修,还停在原地。不催,记在这里,下期接着对账。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。
往期推荐 · 《智能体评测落地记》