当前位置:首页>排行榜>医疗 AI 评测平台 InclusionMed 首期榜单:22 个模型最高 49.1 分

医疗 AI 评测平台 InclusionMed 首期榜单:22 个模型最高 49.1 分

  • 更新时间 2026-11-19 11:55:19
医疗 AI 评测平台 InclusionMed 首期榜单:22 个模型最高 49.1 分

312 道题改编自《新英格兰医学杂志》刊载的麻省总医院疑难病例。出题人删掉了最后的诊断,只留下病史、查体、化验和一路走偏的会诊记录。模型要给主诊断,还要讲清依据。

这套题叫 InclusionMed-DxFiles,题库不公开。11 月 18 日 InclusionMed 上线,它和另外四项公开基准一起构成了首期指数。平台由 29 家机构的研究人员共建。名单里有斯坦福大学、哈佛大学、北京协和医学院和蚂蚁集团。技术报告 11 月 16 日先发在 arXiv 上,编号 2611.21218。

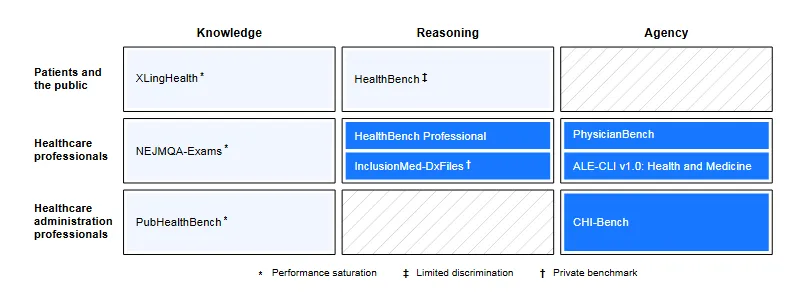
平台放出两样东西。一样是 InclusionMed Atlas,一张评测图谱。横轴是服务对象:患者与公众、医疗专业人员、医疗管理人员。纵轴是能力:知识、推理、任务执行。两轴交叉出 9 个格子,每项基准按主要内容归位。另一样是 Index,把入格基准的成绩汇总成一个总分。

01

ATLAS

九宫格只填了 3 格

首期 9 个格子只填了 3 个。空得最彻底的是「患者与公众」整行,一项基准都没有。「知识」这一列也没有单独的基准入格。报告的解释是,适合评估多元医疗角色的公开基准仍然稀缺。

02

BENCHMARKS

388 个候选,留下 5 个

选基准花的工夫比评测本身还多。团队从论文、公开平台和社区收集了 388 个候选,每个建一张卡片。筛选先看医疗相关性,再看可信度与授权,最后看覆盖互补和区分度。筛到 8 个进入独立复现。XLingHealth、NEJMQA-Exams、PubHealthBench 三个被排除,理由是分数饱和。模型在上面普遍考得太好,分不出高下。HealthBench 栽在区分度上,模型之间的差距太小。

留下的四项公开基准,加上自建的 DxFiles,就是首期全部家当。

基准
任务数
考什么
HealthBench Professional
525
医生提问下的回答质量,按医生制定的评分规则打分
PhysicianBench
100
在模拟电子病历环境里检索信息、执行操作、写记录
ALE-CLI v1.0 医疗子集
22
医学研究中的计算与数据分析,产出可执行代码与分析报告
CHI-Bench
75
美国医疗运营流程,含事前授权、利用管理、照护管理
InclusionMed-DxFiles
312
期刊疑难病例的诊断推理,主诊断与依据
03

INDEX

榜首 49.1 分,不是百分制

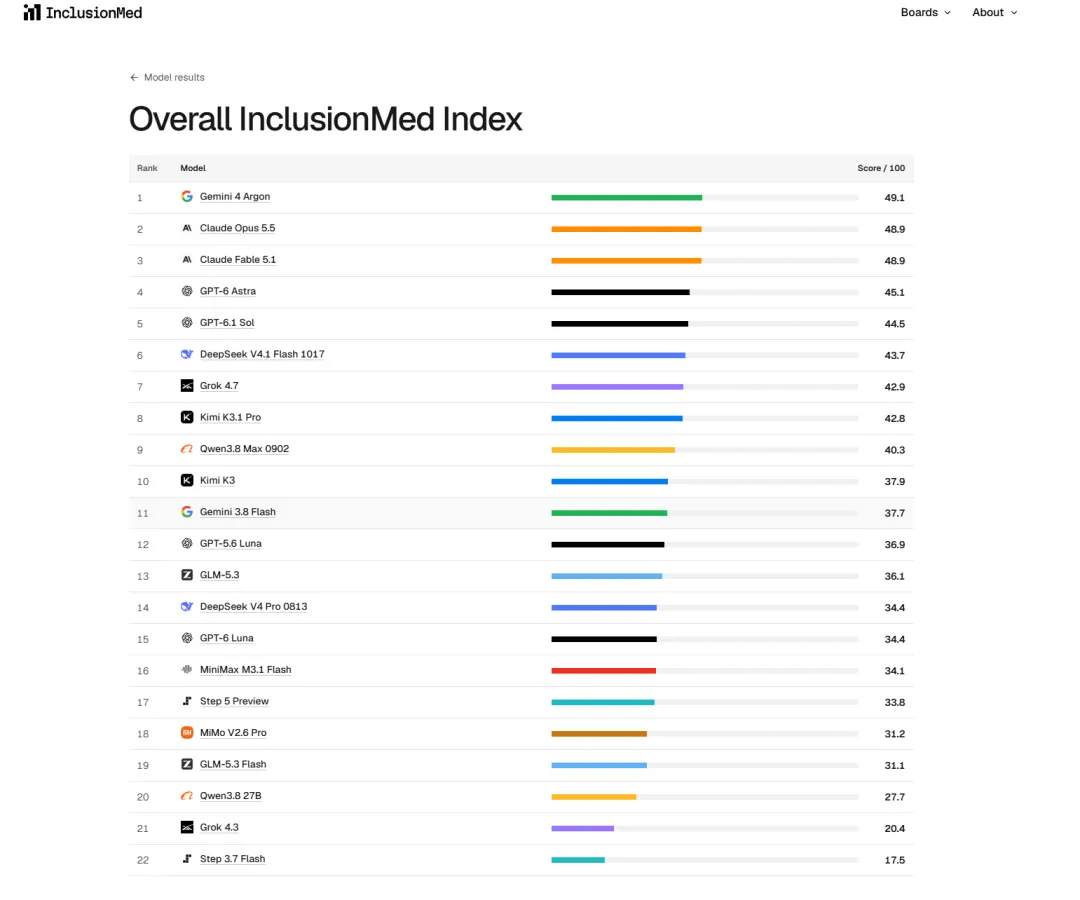
五项等权,各占 20%,合计 1034 项任务。Index 不是百分制,22 个模型的全距是 17.5 到 49.1 分。

第一名 Gemini 4 Argon 是 49.1。Claude Opus 5.5 与 Claude Fable 5.1 并列第二,48.9 分。GPT-6 Astra 45.1,GPT-6.1 Sol 44.5。往后是 DeepSeek V4.1 Flash 和 Grok 4.7,再往后是 Kimi K3.1 Pro、Qwen3.8 Max。第十名 Kimi K3 是 37.9 分。

04

FINDINGS

沟通分高,决策分低

总分只说明一半。Index 另按角色和能力分列给分。面向医疗专业人员这一列,Claude Opus 5.5 以 55.6 领先。推理能力上 GPT-6 Astra 拿到 58.7,任务执行上 Claude Fable 5.1 是 46.1。同一个模型换个格子就换位置。GLM-5.3 在专业人员维度排第 14,在医疗管理人员维度排第 4。

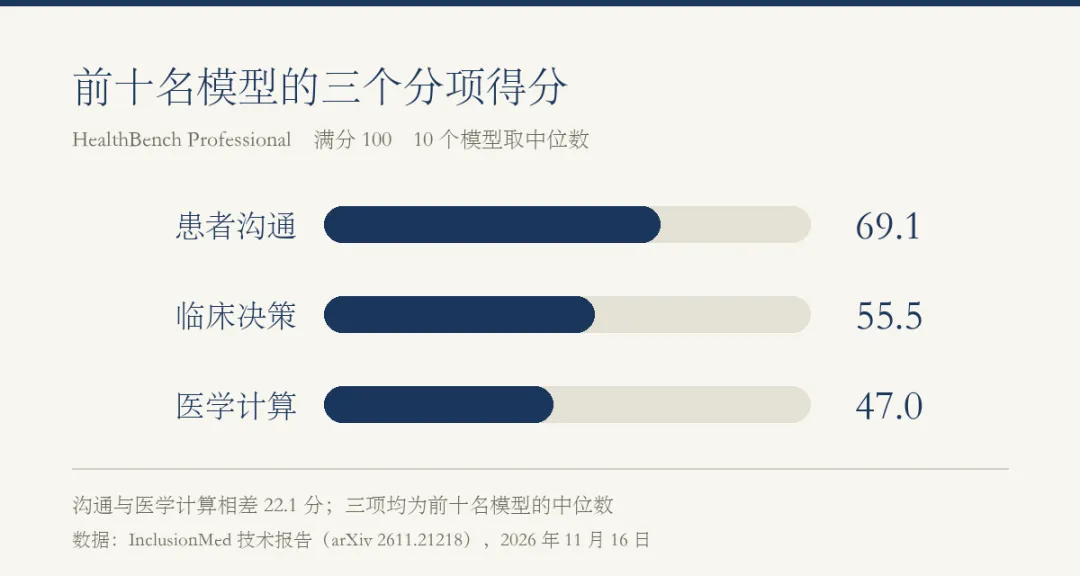
报告里最能说明问题的是分项。HealthBench Professional 的前十名,患者沟通中位数 69.1,医学理解 60.5,循证医学 58.7。往下是临床决策 55.5 和安全与伦理 48.8。垫底的是医学计算,47.0。十个模型无一例外,沟通分都高于临床决策分。

工作流上是同一条曲线。医疗服务与管理 78.5,临床评估与诊断 59.1,治疗规划与实施 53.0。PhysicianBench 里 10 个模型有 8 个重复了这个规律。评估诊断中位数 57.1,治疗规划 50.0。两件事在分数上分得很开。

执行环节的账更难算。PhysicianBench 把一次就诊拆成 670 个检查点,覆盖 21 个专科。模型要在 FHIR 标准的电子病历里查资料、下操作、写记录,全部通过才算成功。912 个失败检查点中,临床推理占 51.4%。按类内失败率看,行动执行 17.4% 最高,文档记录 14.6%,数据检索只有 4.9%。

这类任务长这样。医生说一句「把 3 床的万古霉素按肾功能调一下,改完病程记一笔」。模型要打开患者页,翻出最近一次肌酐,核对体重和用药记录。然后改医嘱,写一条带时间戳的病程;任何一步点错位置,整题判失败。这类任务首期只有 100 道,占全部任务不到一成。它也是最接近医院里正在试的那批智能体的部分。
05

COST

同分不同价

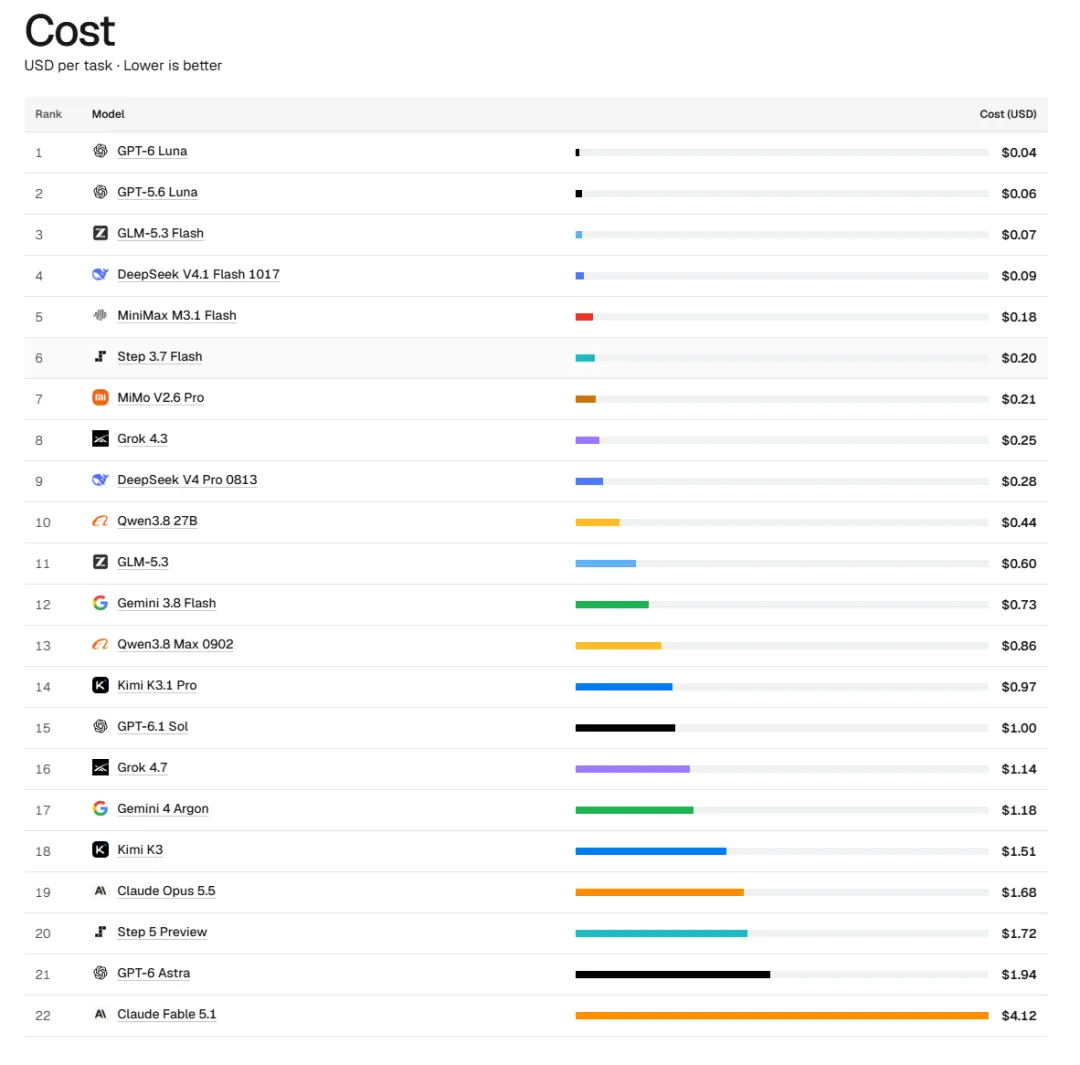
报告也算了钱。分数相近的模型,跑完一次任务的平均成本差约 24 倍。Kimi K3 得 37.9 分,每次 1.51 美元。GPT-5.6 Luna 得 36.9 分,每次 0.064 美元。同样 48.9 分的两个 Claude 也不一样,Fable 5.1 每次 4.12 美元,Opus 5.5 是 1.68 美元。成本按 token 用量和截至 11 月 13 日的公开价格估算。重试、评审和沙盒费用没有算进去。

06

LIMITS

93% 的英语题,99.8% 的纯文本

首期的边界写得比成绩更清楚。1034 项任务里,964 项是英语,占 93.23%。1032 项只输入文本,占 99.81%,需要看医学图像的只有 2 项。能确定地理背景的 338 项中,318 项涉及美国医疗体系。388 个候选基准里,只有 104 个提供了足以直接复现的材料。

DxFiles 自己也有两处待查。病例来自公开发表的期刊文献,模型是否在训练中见过原文,报告承认要持续验证。评分用了 GPT-6.1 Sol 辅助打分,一致性与偏差同样待观察。

独立性还有一层。蚂蚁集团既是 29 家共建机构之一,也是 11 月 18 日那篇中文稿件的提供方。量子位在文末注明「本文由 InclusionMed 提供,获授权转载」。平台把自己定位成独立评测方。这个定位接下来要看逐模型结果与方法细节公开到什么程度。

下一步已经写进报告。项目组要和医疗机构、研究团队合作,开发两类新任务。一类是复杂治疗选择中的医患共同决策,另一类是资源约束下的诊疗调度。九宫格剩下的格子由此补上。平台同时说明自己是开放协作项目,接受社区提交基准。

首期 5 项基准、1034 项任务,填满的是 9 个格子里的 3 个。剩下 6 个,还没有对应的公开基准。

END

随机文章