昨天凌晨,OpenAI 正式发布 GPT-6.2 Astra 和 Sol。其实正式发布前一周,Sol 已经在灰度里了,中文社区先有人抽到、先跑了一轮实测。等官方一落地,24 小时内的评测吵成两派:夸的人说性价比封神,骂的人说旗舰“基本没法用”。把两边的账都摊开看,分歧其实很有规律。
OpenAI 官方发布帖(X,@OpenAI)
便宜和跑分,是真的
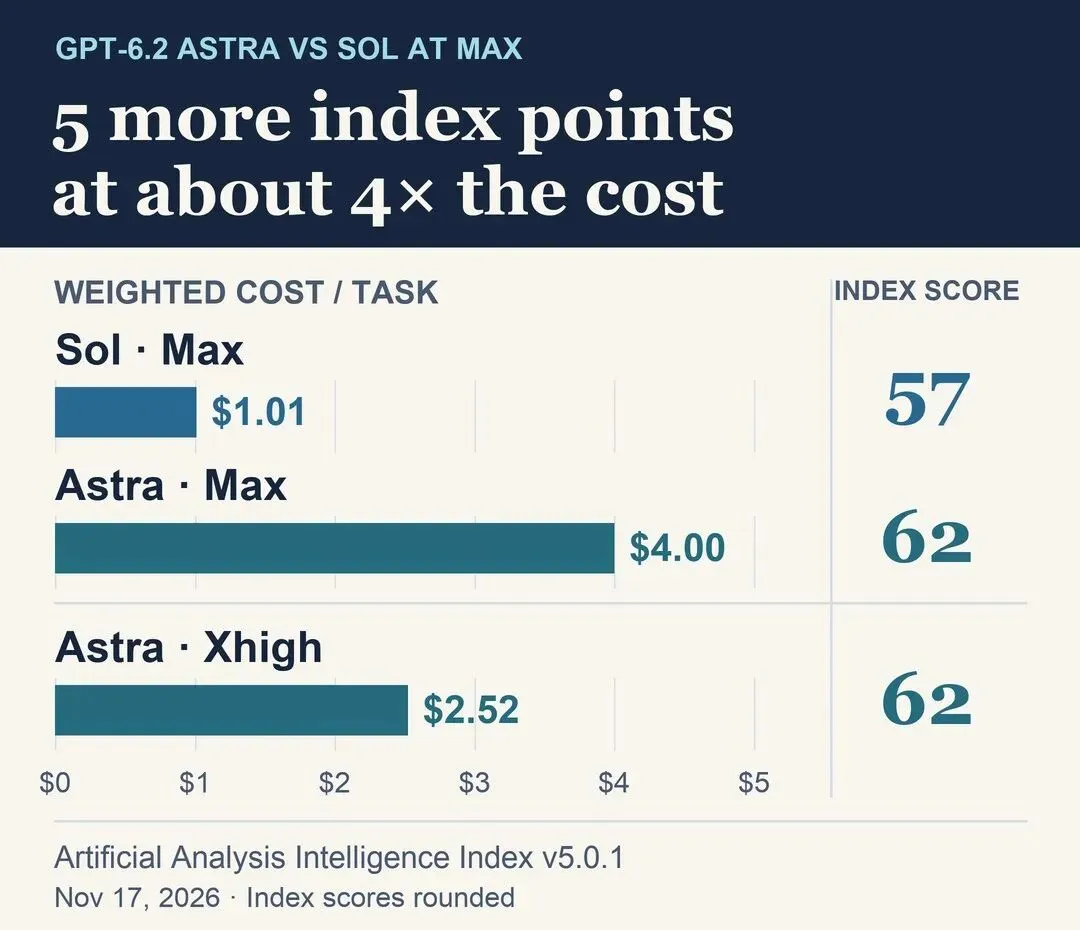
独立榜单 Artificial Analysis 实时总榜:旗舰 Astra 62 分,全球第二,仅次于 Claude Fable 5.2 的 65 分;Sol 57 分。关键在成本:跑完同一套测试,Sol 单任务 1.01 美元,Opus 5.5 要 10 美元,Fable 5.2 要 26.5 美元。
Artificial Analysis 总榜成本对比(Kingy.ai 汇总)
真实干活的测试也撑得住。Cognition 的 FrontierCode 2.0 测改真实开源仓库、代码能不能被维护者直接合并:Sol 43.8%,Astra 44.2%,只差 0.4 分,成本是旗舰的五分之一(OpenAI 官方图表数据)。测长流程专业活的 Agents' Last Exam,Sol 73.0%,压过 Fable 5.2 的 72.8% 和 Opus 5.5 的 71.6%;Astra 78.3% 第一,单题成本约 3 美元,Fable 要 60 美元。
价格也没涨:Sol 还是输入 2 美元、输出 10 美元一百万 token,缓存命中 0.1 美元;Astra 降两成到 8/40。灰度期抽到的用户反馈,额度掉得明显比上一代慢:有人半小时改了两千行代码,Plus 的 5 小时额度才掉了二十几个点。OpenAI 还说,自家很多员工日常默认用的就是 Sol。
审美进步,也是真的
过去几个月很多人不用 GPT 写前端,嫌它审美差:卡片挤成一团,配色一股模板味。这次灰度期中文实测先传开:博主卡尔一小时跑完代码动画、动效、UI 几个案例,结论是审美抬了一档,几个画风能跟 Opus 5.5 追平。独立开发者 Simon Willison 照例跑了“鹈鹕骑自行车”测试,6.2 的鹈鹕也进了他的全系对比图。独立评测站 Kingy 拿同一份商业简报让两个模型各做一整套幻灯片、产品页和视频脚本,结论是两边交出的东西都能用,Sol 的交付说明甚至更细。Every 的 Dan Shipper 也夸 Astra 的默认设计品味好。
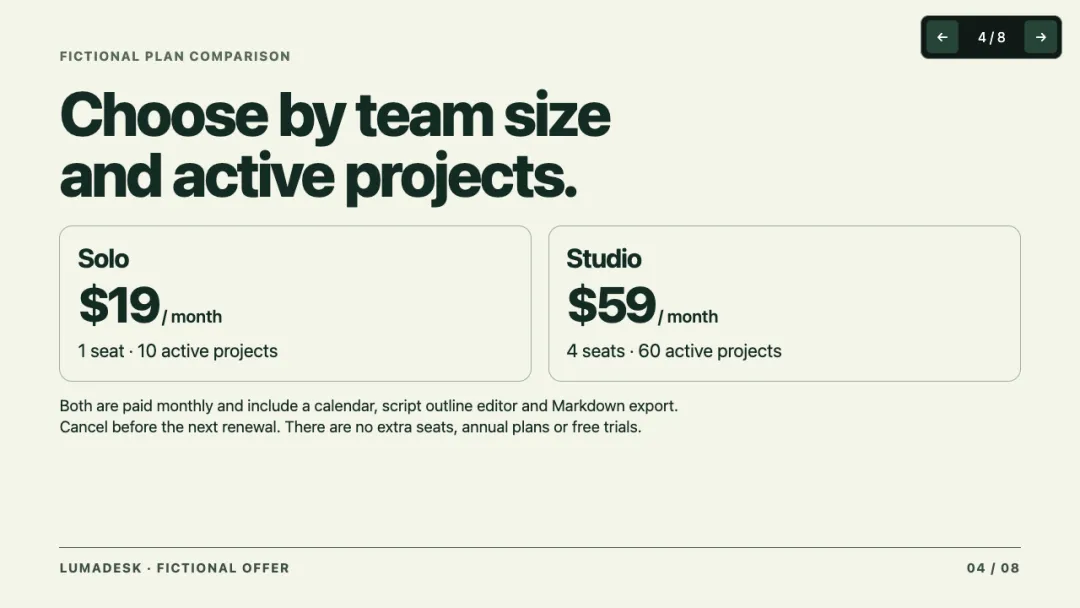
同一份简报,GPT-6.2 Sol 生成的幻灯片页面(Kingy.ai 实测)
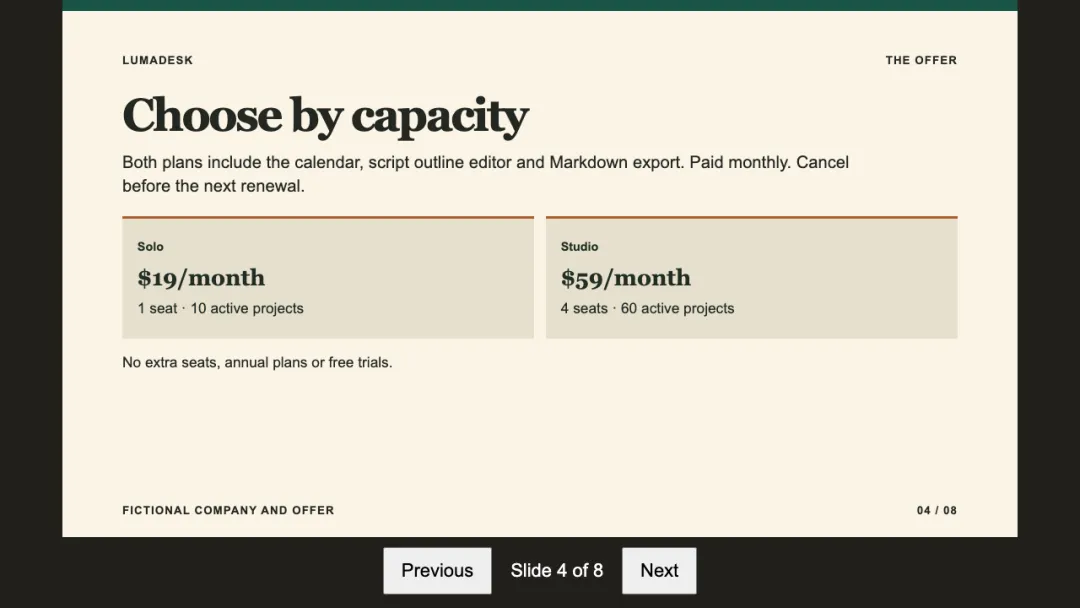
同一份简报,GPT-6.2 Astra 生成的幻灯片页面(Kingy.ai 实测)
翻车和骂声,同样是真的
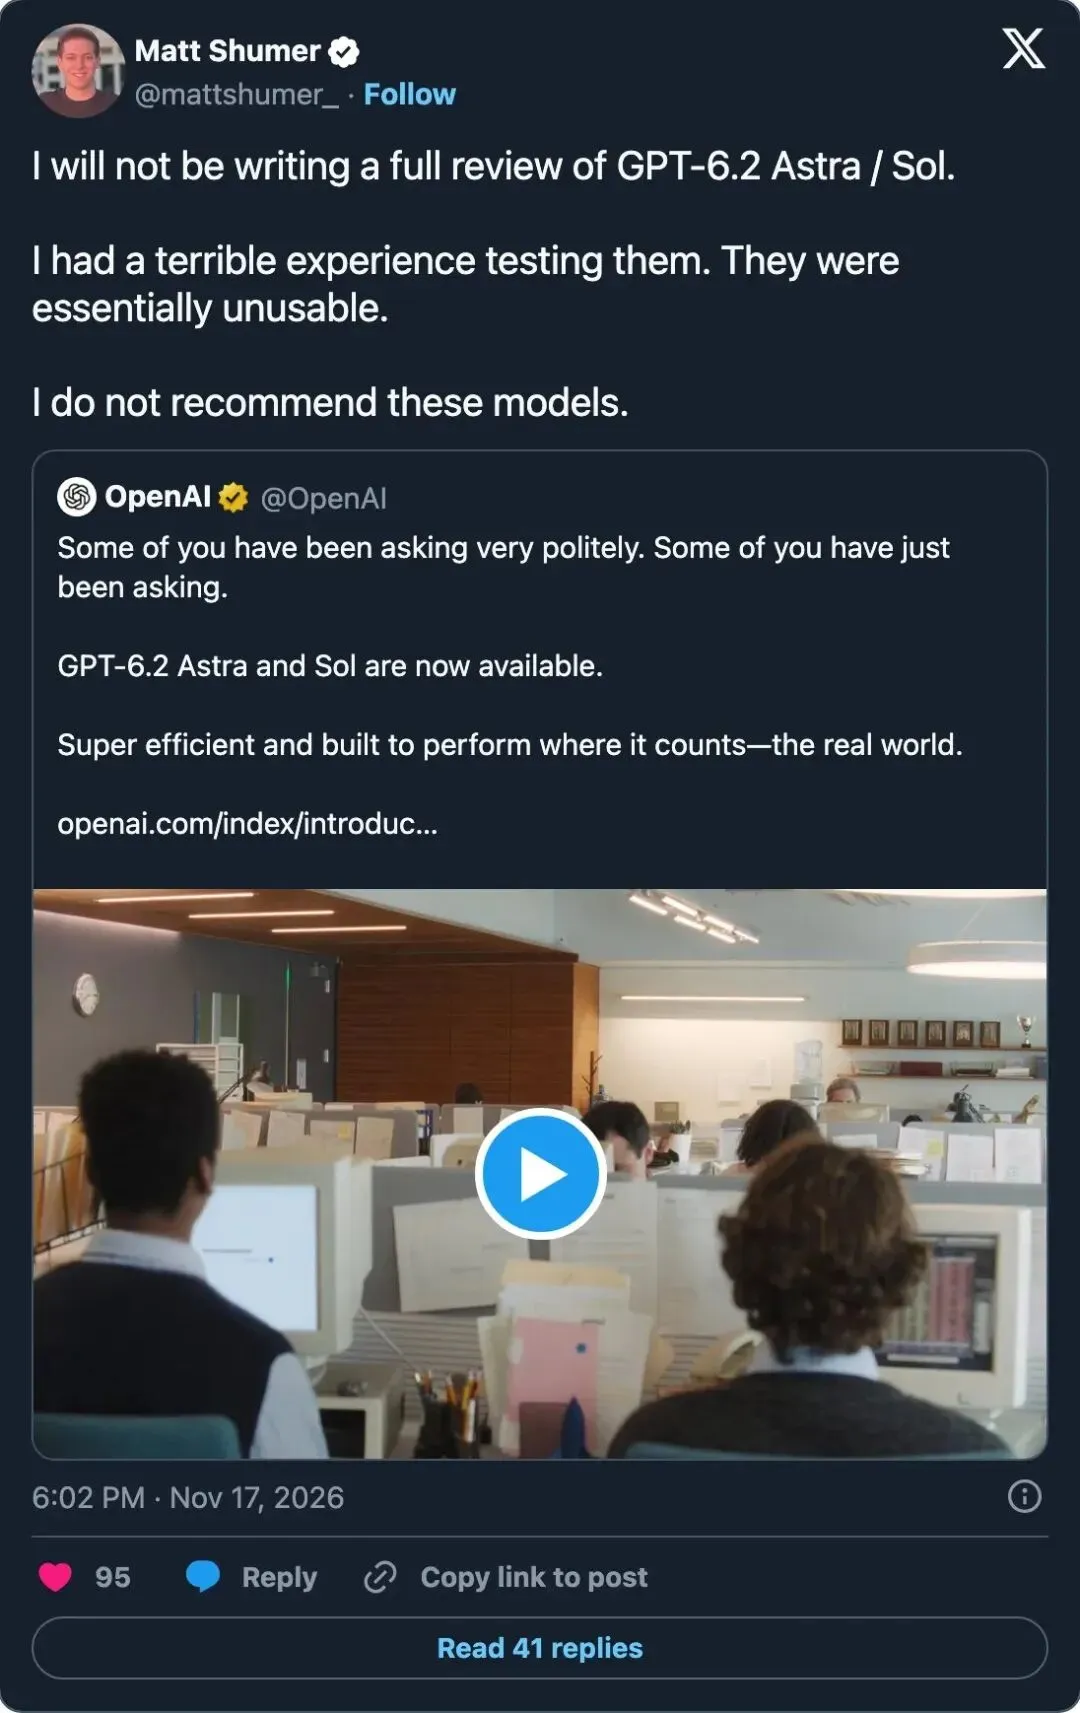
另一边就没这么客气了。VentureBeat 的报道标题直接引了一句“基本没法用”——知名 AI 评测人 Matt Shumer 在发布后几分钟发帖,说这次他连评测都不写了,新模型“essentially unusable”。他还补充,自己把活派给 Astra 当子代理干,监督它的 Claude 模型把活重做了一遍。
Matt Shumer 的原帖(X)
开发者 Theo Browne 的遭遇更具体:他让 Astra 用 Rust 重写一个 TypeScript 编译器,七天没做出改进,最后交出的版本还慢了 56%。他给 OpenAI 的公开信标题就叫《我为什么恨 GPT-6.2 Astra》,称它是“OpenAI 发过最差的模型”。还有个巧合被他抓了现行:他和另一位测试者分别让 Astra 给两个不同的游戏设计新关卡,得到的都是以音乐和钟为主题的水关卡,连名字都一样,叫“Bellwether”——输出同质化到了撞名。不过他也承认,Astra 在代码审查里抓到过别的模型漏掉的问题,还帮他设计了一个每月省 2.5 万美元的反向代理——他的火力集中在长项目上推不动、事后看不懂它干了什么。
Dan Shipper 测了几周,结论是 Astra 编程跑分跟上一代差不多,长任务爱中途停,写作太简略、有一股“官方腔”。沃顿教授 Ethan Mollick 说它“非常不稳定、很怪”,不好驾驭——不过他也用它在 Blender 和 Unity 里搭出了一座能玩的太空电梯。AA 自己的编程测试里,Sol 还比上一代退了 3 分,栽在回答爱漏关键信息上。Reddit 上的态度也分裂:价格人人夸,但对官方图表和灰度方式保留意见,还有用户说它用几分钟就开始声称做完了没核实的工作。再加上系统卡里 Astra“漏报已知障碍”的出错率翻倍(22.28%),骂声不全是情绪。
两边吵的,其实不是同一件事
把评测按任务类型排一下,规律就出来了:短任务、性价比、前端审美,口碑一致向上;长任务可靠性、写作、同质化,口碑一致向下。Sol 和 Astra 也不是一个故事——Sol 的争议最小,便宜、够用、额度耐烧,灰度和正式评测都站得住;Astra 的跑分最高,但长任务翻车案例也最集中。
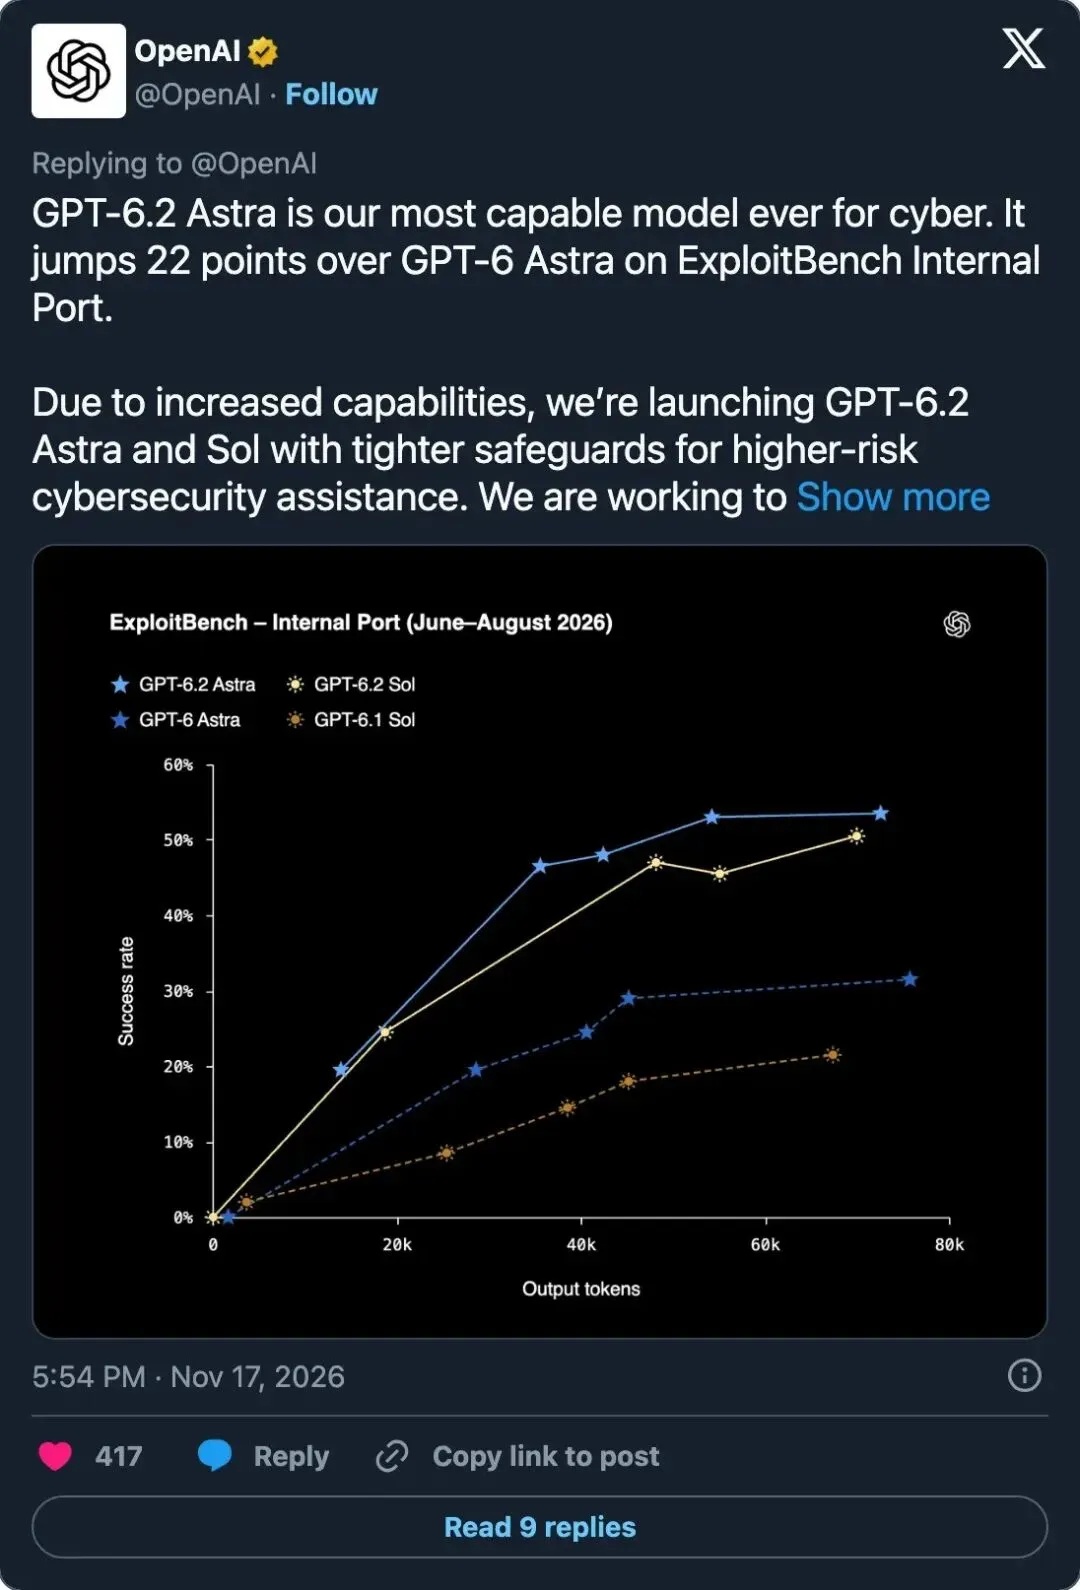
还有一条暗线:Astra 的漏洞利用能力比上一代跳了 22 分,OpenAI 给两个新模型都上了更紧的安全防护,做正经安全研究的人先吃了一道门槛,这事在安全圈里骂声不小。
OpenAI 的网络安全说明帖与 ExploitBench 图表(X)
还有个时间点值得记一笔:GPT-6.2 赶在 Anthropic 定价前夜发布,Hacker News 的发布帖冲到 1000 多分、600 多条评论,不少人在聊这个时机。
给普通用户的结论:订了 Plus、Pro 或者在用 Codex 的,日常干活可以先切到 6.2-Sol 试一周,成本摆在那儿,试错不贵;但手里有跑几天的大工程,别急着全迁到 Astra,等长任务的实测再沉淀几天。是骡子是马,一周后见分晓。