2026 年 11 月 9 日,Addy Osmani 在 claude.dev 发表《Which Claude model should you build with? Fable, Opus, Sonnet, or Haiku》,讨论怎样为不同任务选择 Claude 模型、比较成本,以及让多个模型分工。文章既给出起步建议,也解释提高推理投入、切换模型和使用子 Agent 各有什么代价。
当时,Claude 面向所有用户普遍开放的型号有四款:Haiku 5.5、Sonnet 5.5、Opus 5.5 和 Fable 5.2。Mythos 5.2 则是 Anthropic 在网络安全与生命科学研究领域能力最强的模型,通过认证计划开放访问。
使用 Claude Platform 开发应用,或在 Claude Code 里工作时,常见任务到底该交给哪一款?这篇指南围绕这个选择,以及选择背后的取舍展开。下文的型号、价格与平台差异,均以这份 11 月 9 日的指南为准。
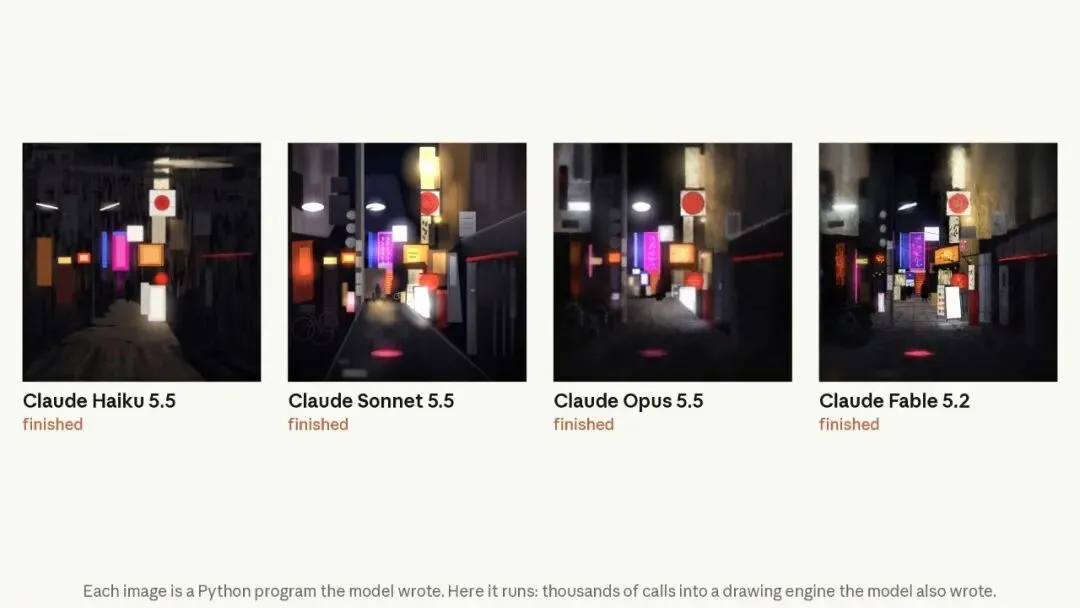
图 A:Haiku 5.5、Sonnet 5.5、Opus 5.5 与 Fable 5.2 用代码重现同一张小巷照片。每幅画都是模型编写的 Python 程序调用自己编写的绘图引擎生成的,演示展示了从第一层到完成的过程。演示:Lance Martin。
多数工作,先从 Opus 5.5 的 medium 开始
指南给出的简短建议是:多数任务先用 Opus 5.5,推理投入保持默认的 medium。
Opus 5.5 成为 Claude Code 的默认模型有其原因:输入和输出 token 单价都只有 Fable 5.2 的一半,也是 Anthropic 建议用于大多数编码和知识工作的起点。
然后再根据任务调整:
- 边界明确的日常工作,例如修复一个 bug,或按照规格实现一个功能,可以降到 Sonnet 5.5。但“规格清楚”不自动意味着任务简单。一次迁移或性能优化即使有清晰要求,仍可能难到需要 Opus 5.5;大型任务甚至需要 Fable 5.2。
- 分类、路由、信息抽取等最简单、量又大的任务,可以进一步降到 Haiku 5.5。它也适合担任子 Agent,处理大模型主任务之外的辅助工作。
- 编码、金融和科学领域最困难的技术项目,适合升到 Fable 5.2。Opus 5.5 在
high 下仍达不到要求,或需要长时间无人看管地运行时,也可以考虑它。
换模型之前,先尝试调整 effort,也就是模型的推理投入等级。相比直接换型号,这个旋钮能更细地调节成本与能力。超过 high 后,再提高一个等级,成本可能已经相当于使用更大的模型,因此要在自己的任务上比较。如果已经超过 high,不妨测试更大一档模型在较低 effort 下的表现。反过来,降低一级 effort,也可能以更低成本得到足够好的结果。
当模型需要思考更久、调用更多工具或更认真地检查自己的工作时,提高 effort 会有帮助,但也会增加等待时间。它也不能凭空补上模型尚未掌握的知识或技能;缺的是这些能力时,仍然需要更大的模型。
按任务选择起步模型
指南按任务给出的建议如下。这里的“起步”表示先测试这一组合,再根据自己的结果调整。
- 日常工程、调试,以及跨多个代码合并请求(PR)的功能开发: Opus 5.5,先用默认的
medium,再考虑 high。它在日常任务上兼顾成本和能力。
- 分类、路由、打标签和大批量抽取: Haiku 5.5,先用默认的
medium。它是这一模型系列中成本最低、延迟最小的选择。
- 查文件、读日志、做摘要的子 Agent: Haiku 5.5 或 Sonnet 5.5,使用各自默认 effort。这类错误容易被发现,而需要判断的地方本来就由主模型负责。
- 聊天与交互会话: Sonnet 5.5,先用
low 或 medium;简单而且量大的聊天也可用 Haiku 5.5。Sonnet 5.5 在这两个 effort 等级下尤其快。
- 边界明确的编码,例如修 bug、迭代功能、按规格开发: Sonnet 5.5,从
medium 开始,较难的任务再升到 high。它适合这类工作,token 单价只有 Opus 5.5 的一半。
- 日常文档、幻灯片和表格: Sonnet 5.5,默认
high,在 Claude Code 中则默认 medium。它迭代快,也有较好的设计判断。复杂财务模型,或需要消化大量原始资料的文档,应从 Opus 5.5 开始。
- 反复执行的 Agent 任务,例如调查、评审、起草: Sonnet 5.5,
medium。明确、重复的任务通常不需要更大的模型。
- 操作电脑,以及大量依赖视觉的工作流: Opus 5.5,
medium。这些任务要围绕许多截图和图像运行较长的 Agent 循环,正是 Opus 5.5 所面向的工作。
- 大型重构、迁移、架构规划,以及带领许多子 Agent: Fable 5.2,从
medium 开始,再考虑 high;它在 API 上默认 high。这是 Anthropic 面向技术领域最强的普遍可用模型。
- 深度研究、科学分析或定量分析: Fable 5.2,从
medium 开始,再考虑 high,API 默认也是 high。它面向最困难的技术项目。
- 还不确定该选什么: Opus 5.5,默认
medium。Claude Code 在 Pro、Max、Ultra、Team、Enterprise 和 Anthropic API 上都默认使用它,平台文档也将其作为起点。
四款模型的能力与价格
四款模型的上下文窗口都是 100 万 token,最大输出都是 12.8 万 token。其余差异可以按模型逐一看。下面均为 Claude API 标价,单位是每百万 token 的美元价格;基准结果见 Fable 5.2 页面。
Haiku 5.5
- 提示词不超过 10 万 token 时,输入/输出为 0.10/0.50 美元;超过 10 万时为 0.50/2.50 美元。
- 缓存读取分别为 0.01 美元和 0.05 美元。
Sonnet 5.5
- 主要为范围明确的工作提供快速、足够强的帮助,相对延迟较低。
- 输入/输出为 2/10 美元,缓存读取为 0.10 美元。
- 自适应思考默认开启;
between_tools 可以跳过一开始的思考,只在工具调用之间思考。
- API 默认 effort 为
high,Claude Code 中为 medium。
Opus 5.5
- 定位为复杂编码与知识工作的日常主力,相对延迟中等。
- 输入/输出为 4/20 美元,缓存读取为 0.20 美元。
Fable 5.2
- 主要用于最有挑战、边界开放的技术工作,相对延迟中等。
- 输入/输出为 8/40 美元,缓存读取为 0.20 美元。
- API 默认 effort 为
high,Claude Code 中为 medium。
Claude Code 的默认 effort 可能与 API 不同,可以用 /effort status 查看当前值。
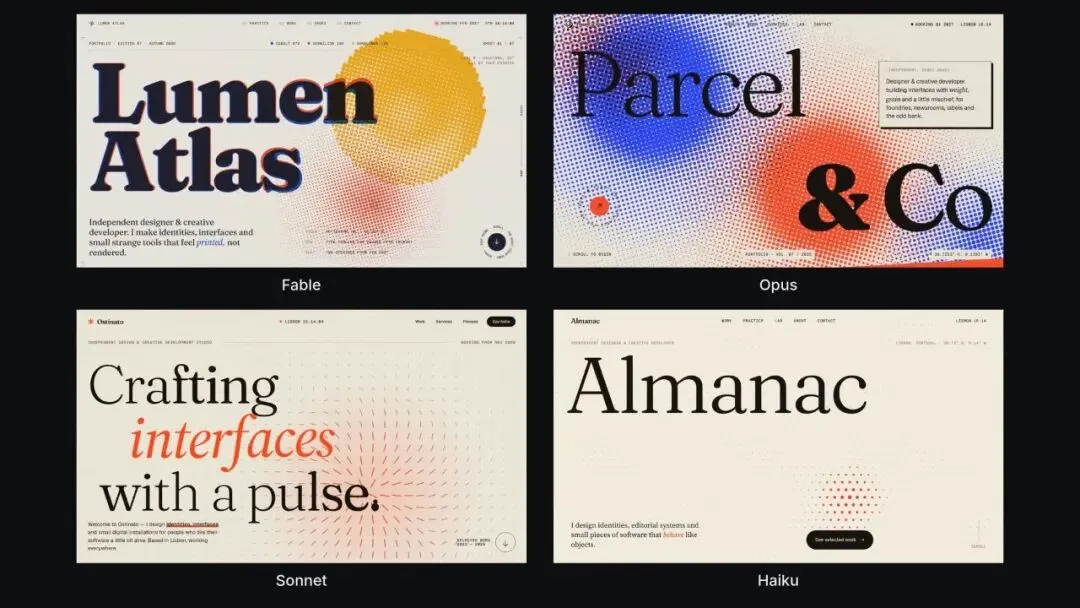
图 B:Fable 5.2、Opus 5.5、Sonnet 5.5 和 Haiku 5.5 各自构建同一个作品集网站,结果并排展示。演示:Addy Osmani。
选择模型时,需要取舍什么
例如,选择更大的模型,通常是在用更多等待时间换取能力。指南重点讨论了三组取舍。
能力与完成任务的成本
一般来说,大模型的 token 更贵,能力也更强,但这种关系并不总能直接推到整项任务。
每个 token 更贵,不代表完成任务一定更贵,也不保证结果一定更好。 在 Spending your effort 展示的 Anthropic Terminal-Bench 3.0 实验中,上一代 Fable 5.1 在 max 下得分为 58.0%;Opus 5.5 在 high 下为 58.9%,却只用了大约一半 token。
在最困难的任务上,型号之间的价格差距还可能收窄。FrontierCode 2.0 中,Fable 5.2 的 high 与 Opus 5.5 的 max 得分大致相同,分别为 45.3% 和 45.5%,但前者每项任务的成本大约只有后者的一半。所以,遇到难任务、准备将 Opus 5.5 调到 high 以上时,先测试 Fable 5.2。日常工作仍以 Opus 5.5 的 medium 作为起点。相关结果见发布文章。
不过,Claude Platform 的成本与智能表现测量也展示了小模型的边界:它们通常适合输出能检查的大批量工作,对长时间运行的 Agent 循环则没那么合适。
比较两个模型时,除了典型任务,也要给最难的任务算账,因为主要费用往往集中在难题上。在一个包含 20 道题的搜索基准中,仅两道题就贡献了总支出的 43%。
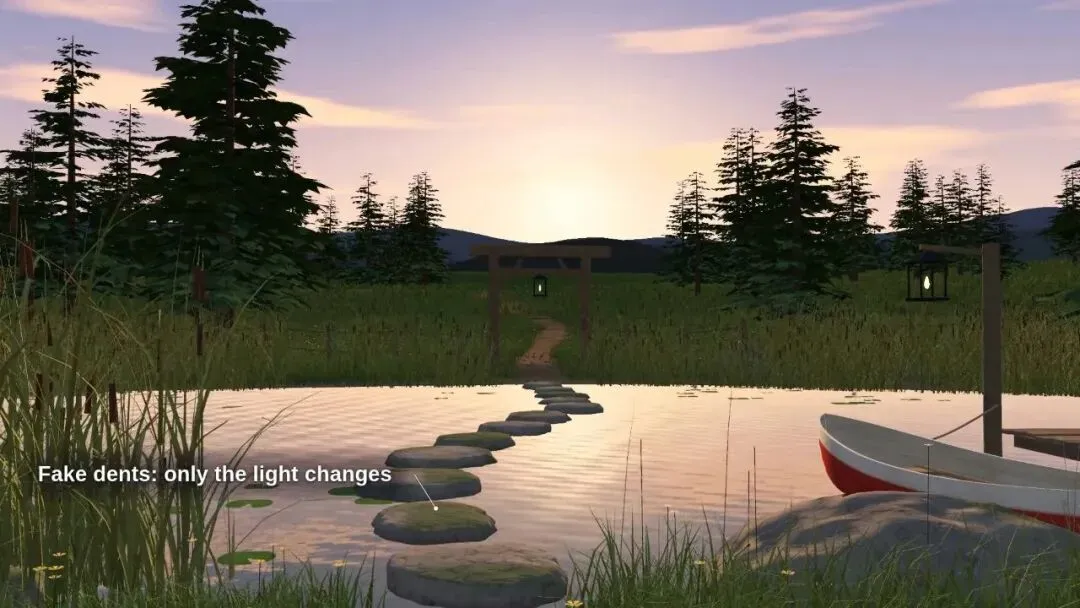
图 C:Fable 5.2 展示游戏引擎怎样构建世界。它用十六种视觉风格绘制同一三维场景,从线框、像素画到光线追踪,并标注各项技术。演示:Dan Fein。
延迟与准确率
更快的配置可以更早完成,但也可能漏掉更多内容。先想清楚人愿意等多久,再选模型和 effort。需要让用户当场等待的回复,可以从 Sonnet 5.5 的 low 或 medium 开始。
新一代模型也常比上一代更快。Fable 5.2 的输出生成速度相较 Fable 5.1 最高快 30%;Sonnet 5.5 比 Sonnet 5 快 30%。
effort 与延迟大体正相关,需要判断准确率的提升是否值得增加的等待。例如在 SWE-bench Pro 中,相比 high,Opus 5.5 的 medium 得分约低 2.5 个百分点,费用约为 70%;low 约低 8 个百分点,费用约为三分之一;xhigh 约高 1.4 个百分点,费用却达到 2.5 倍。
给模型提供检查自己工作的办法,往往比调整 effort 更省钱,也更少增加延迟。模型表现不足时,指南建议依次这样做:
- 先检查它有没有自我验证的途径,例如测试、构建,或一个调用端点检查结果的脚本。
- 升到下一档模型,但从比小模型更低的 effort 开始。
如果能自动检查结果,可以先让所有任务以低 effort 运行,只把失败任务用高 effort 重跑。在同一个 SWE-bench Pro 子集上,Opus 5.5 先用 low、失败后改用 high,通过率约为 97%,每项成本约 0.17 美元;全部使用 high 的通过率为 95.3%,每项约 0.29 美元。
如果希望同一款模型更快回复,也可以付费购买速度。Claude API 上的 Opus 5.5 和 Fable 5.2 都提供 fast mode,以更高价格换取更快的输出。
上下文与成本
这一代模型都有 100 万 token 上下文窗口。大上下文能帮助完成任务,但每轮都要重发上下文,因此也会逐轮计费。不过,长任务中大部分输入按缓存读取计费。
Opus 5.5 每百万 token 缓存读取为 0.20 美元,Sonnet 5.5 为 0.10 美元。Fable 5.2 的缓存读取也是 0.20 美元,因此在缓存占比高的长任务中,Fable 与 Opus 的差距主要来自未缓存输入与输出;这两项上 Fable 的 token 单价为 Opus 的两倍。
What a task costs on Opus 5.5 给出的例子是:上下文为 15 万 token 时,一轮缓存读取大约 0.03 美元;2 万 token 时约 0.004 美元。
这意味着,主模型越大,主上下文保持精简就越重要。昂贵模型的上下文留给判断,冗长的阅读工作可以交给便宜的子 Agent。
Haiku 5.5 是这几款中唯一按提示词长度分档定价的模型。不超过 10 万 token 的提示词按低价档计费,超过后单价变为五倍。即便如此,长提示词档的 token 价格仍是 Sonnet 5.5 的四分之一。Haiku 5.5 在短提示词上尤其划算:输入单价只有 Sonnet 5.5 的二十分之一。
如果每次调用都需要长提示词,就应比较 Haiku 5.5 与 Sonnet 5.5 完成整项任务的成本,而不只是标价。
让不同模型分工
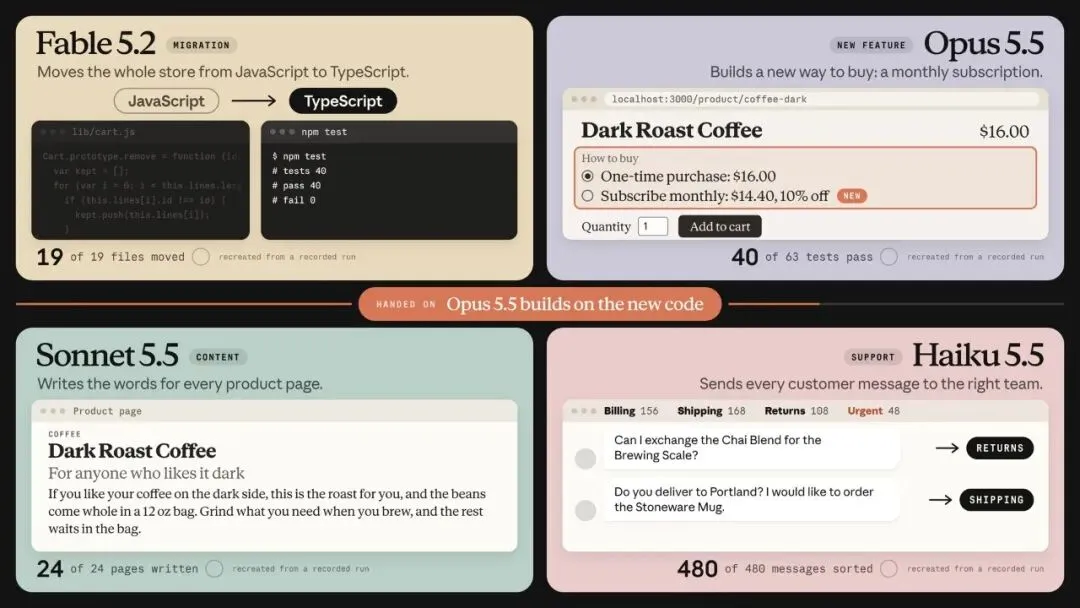
图 D:一个项目,四款模型各负责一种工作。Fable 5.2 将网店从 JavaScript 迁移到 TypeScript,Opus 5.5 构建按月订阅功能,Sonnet 5.5 编写产品页面,Haiku 5.5 分类客户消息。Fable 5.2 的新代码到位后,Opus 5.5 才开始开发其功能。演示:Dan Fein。
在自然的任务边界切换模型
提示词缓存属于创建它的模型。切到新模型后的第一轮,需要为整段对话支付缓存写入费用。为了缩小这一轮,可以先在 Claude Code 中执行 /compact,或用一份简短的书面计划开启新会话。在 API 上,则可以用此前工作的摘要开启新模型对话,不必传入完整历史。
每个思考块都会记录生成它的模型,而一种模型只能读取部分其他模型的思考块。在 Claude API 和 Google Cloud 上由 Google 托管的 Claude Models 中:
- Opus 5.5 可以读取 Sonnet 5.5 和 Haiku 5.5 的思考块。
- Sonnet 5.5 可以读取 Haiku 5.5 的思考块。
- Fable 5.2 可以读取 Opus 5.5、Sonnet 5.5 和 Haiku 5.5 的思考块。
- 在 Claude API 上,Fable 5.1 可以读取 Opus 5.5 的思考块。
向较低一档模型切换时,先前的推理会丢失,因为低档模型不能读取高档模型的思考块。其他切换也可能丢失推理:当新模型无法读取先前模型的思考块时,API 会丢弃这些块,请求仍然成功,但新模型是在没有这部分推理的情况下继续工作。
Preserved thinking 文档列出了全部情况。从 Fable 5.2 切到任何其他普遍可用模型,都会丢掉它的推理。
用小模型运行子 Agent
子 Agent 在自己的上下文窗口中运行,再将摘要交回来。它消耗的 token,按它所用模型的费率计费。在 Claude Code 的子 Agent 定义中,可以设置 model: haiku 或 model: sonnet。对于没有指定模型的子 Agent,环境变量 CLAUDE_CODE_SUBAGENT_MODEL 可以设置默认值。
下面的定义保存为 .claude/agents/log-reader.md:
MARKDOWN
--- name: log-reader description: Reads test output and logs, and reports each failing case. Use after a test run. tools: Read, Grep, Glob, Bash model: haiku --- Read the logs you're given. For each failure, report the file, the test name and the first error line. Don't edit any files.
它让子 Agent 在测试结束后阅读给定日志,逐个报告失败所在的文件、测试名和第一条错误信息,同时明确不修改文件。
指南建议把小模型留给错误容易被发现的工作,例如查找文件、运行测试、阅读日志;代码修改和需要判断的决策留给主模型。如果小模型误读了搜索结果,主模型就可能打开错误文件,继续为它花费 token。
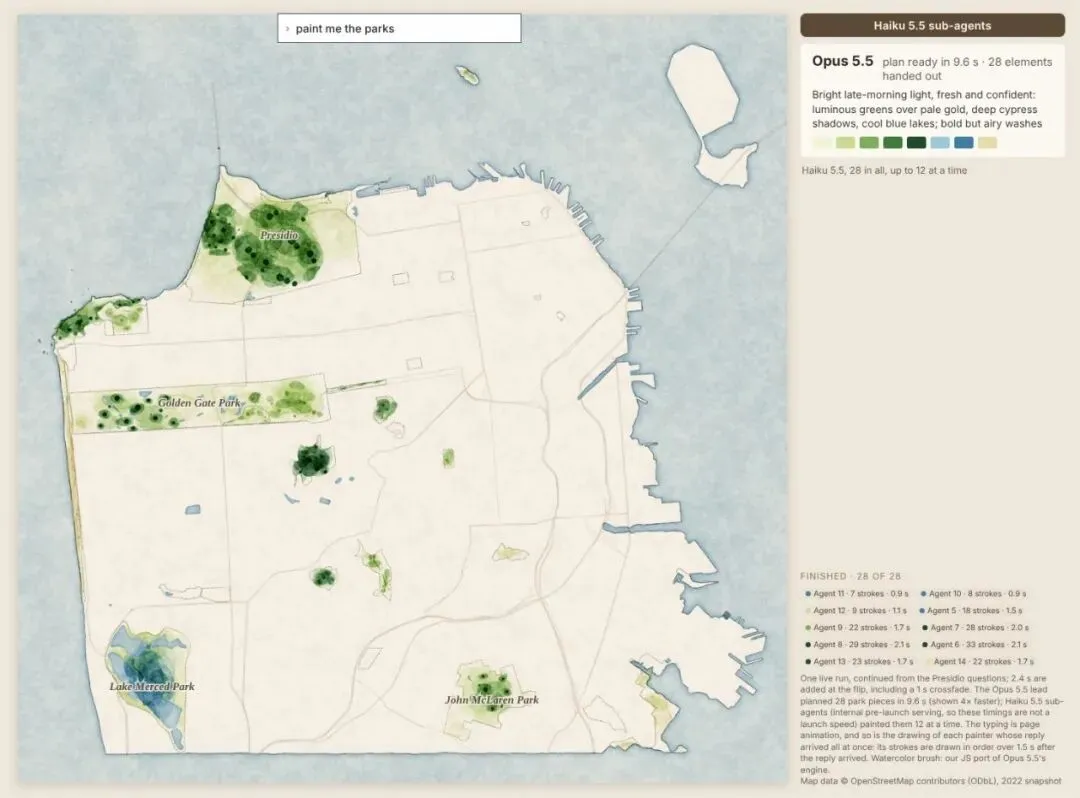
图 E:用户请求一层信息,例如海拔、自行车路线、雾或温度。Opus 5.5 规划工作,并行的 Haiku 5.5 子 Agent 在共享地图上绘制各部分。温度仅用于演示,雾是视觉表现,不是天气预报。地图数据 © OpenStreetMap 贡献者;高程来自 USGS 3DEP 激光雷达数据。演示:Lance Martin。
在当时版本的 Claude Code 中,内置 Explore 子 Agent 使用的是当前会话模型,不再始终使用 Haiku;通过 Claude API 使用时,这个模型最高为 Opus。希望降低探索成本,可以自行定义一个名为 Explore 的子 Agent,并设置 model: haiku。还可以用 ANTHROPIC_DEFAULT_HAIKU_MODEL 固定 haiku 别名对应的型号。
在 Anthropic API 上,haiku 别名当时已指向 Haiku 5.5,需要 Claude Code v2.1.293 或更新版本。在 Amazon Bedrock、Google Cloud、Microsoft Foundry,以及 Claude Platform on AWS 上,它仍然指向 Haiku 4.5。具体差异见 Claude Code 的模型配置文档。
Claude Code 还提供 opusplan 别名:在规划模式用 Opus 做计划,然后由 Sonnet 执行。这样代码修改就交给了 Sonnet,而前面的建议恰好相反:让主模型负责改代码,小模型只处理错误容易发现的辅助工作。将 opusplan 设为默认前,先用自己的任务测量。
把困难决策升级给 advisor
advisor 工具处于 beta 阶段,它把更快、更便宜的执行模型与更强的顾问模型配在一起。执行模型负责推进任务,必要时向 advisor 征求意见;多数 token 按执行模型的费率计费。只有顾问补上了执行者缺少的能力,而且执行者真的发起咨询,它才有帮助。在低 effort 下,执行模型咨询得更少。
它可能适用于大多数轮次都很常规的 Agent 工作。但平台成本指南对这项能力相当谨慎:advisor 表中的四组配对,没有一组明显优于执行模型独立工作。顾问只有被咨询时才能起作用,因此先测量执行者的咨询率,再确认执行者接受哪些顾问。
例如,Sonnet 5.5 执行者接受 Fable 5.2、Opus 5.5、Opus 5 和 Sonnet 5.5;Fable 5.2 执行者则只接受 Fable 5.2 或 Mythos 5.2。
也有收益很小的情况。在一个内部编码基准中,Opus 5.5 执行者使用 high,配合 Fable 5.1 顾问,得分 90.1%,每次尝试 2.92 美元。相比单独使用 high 的 Opus 5.5,多付了约 1.1 倍的费用,总成本约为 2.1 倍,得分只提高 1.7 个百分点。这个增幅接近重复运行的波动范围,也大致是提高 effort 可能带来的收益。
把大量工作拆给便宜的 worker
前面说的子 Agent,是在一个主模型保持任务主线的情况下,承担辅助工作。这里的另一种模式,适合总工作量超过一个上下文窗口的任务:由顶级模型带队,拆分工作,交给许多更便宜的 worker 并行处理,再汇总结果。
在一个覆盖约 2,200 万 token 源码的内部缺陷搜索基准中,Opus 5.5 带领 Sonnet 5.5 worker,最多同时运行 25 个,相比单独使用默认 effort 的 Opus 5.5,费用低约三分之一,得分大致相同。
Claude Platform 上,Claude Managed Agents 的多 Agent 编排可以提供一个协调 Agent 和一组 worker。但如果任务只是依赖关系串联起来的一条流程,或能装进一个上下文窗口,就不适合采用这种模式:规划和合并的成本可能超过节省的部分。何时把子 Agent 合回主循环进一步讨论了单一循环优于多个子 Agent 的情况。
迁移前检查兼容性
选模型主要是在权衡能力和成本,但更换模型名不一定就能完成迁移。当时这几款模型都支持工具调用和图像输入,不过,请求从一种模型迁到另一种模型前,仍要测试这些差异。
Fable 5.2 的保留思考机制。 它把 preserved thinking 扩展到全部 API 账户。如果 Fable 5.2 思考块之前的任何内容发生变化,包括系统提示词、工具或较早的消息,API 会返回 400,除非显式选择丢弃受影响的思考。通过 Claude Code、Claude Agent SDK 或 Claude Managed Agents 构造请求,不必调整;自己写代码修改历史时,则应保持历史只能追加,并在切换前测试。
思考配置。 Opus 5.5 与 Fable 5.2 始终思考,尝试关闭会报错。Sonnet 5.5 默认思考,between_tools 可以将思考限制在工具调用之间。Haiku 5.5 也默认思考,在 high 或更低 effort 下可以关闭。对所有型号,都应按类型读取内容块,因为回复可能以思考块开头。
强制工具调用。 Sonnet 5.5、Opus 5.5 与 Fable 5.2 收到 tool_choice: any 或 tool_choice: tool 会返回 400。应发送 auto,将工具标为 strict: true,并在提示词中说明什么时候使用工具。
操作电脑。 Opus 5.5、Sonnet 5.5、Haiku 5.5 与 Fable 5.2,只通过 Claude API 及 Google Cloud 上由 Google 托管的 Claude Models 的 computer_toolset_20260801 工具集提供 computer use。
从 Haiku 4.5 迁到 5.5。 将 budget_tokens 替换成 effort 等级,并移除非默认的 temperature、top_p 和 top_k;这些采样设置会返回 400。消息应以用户轮次结束,不能以一个让模型继续补写的助手轮次结尾,后者也会返回 400。
安全回退。 Opus 5.5、Sonnet 5.5 和 Fable 5.2 使用安全分类器,最常标记网络安全和生物学内容。Claude Code 中,被标记的请求可能改用旧模型重跑,记录中会显示相应提示。Fable 5.2 延续 Fable 5.1 的回退型号:被标记的网络安全请求回退到 Opus 4.8,生物学请求回退到 Opus 5。
如果一个系统要运行多款模型,就按其中最严格的要求构造每个请求:历史只追加,使用 tool_choice: auto 和 strict 工具,按内容块类型读取回复;提示词和工具描述要足够准确,让最按字面理解的模型也能正确执行。这样,一个步骤升档或降档时,才不必同步修改代码。
路由规则很简单时,例如每类步骤固定对应一个模型,直接让代码选型号,不必再让模型做选择。
在自己的工作上测量
前面的 SWE-bench Pro、Terminal-Bench 等公开结果,提供的是起步位置。决定长期采用前,还要用自己的任务测试候选模型。
- 抽取一批真实任务,为每项写出结果检查,例如测试通过、工单关闭,或行数与预期一致。
- 每个候选模型测两到三个 effort 等级,各自在独立会话中运行,避免共享缓存。根据每次回复的
usage 字段,记录完成每项任务的成本。 - 把得分与花费画在同一张图上。只有多模型配置优于图上每一个单模型配置时,才保留它。
- 正式切换前,先让胜出的配置在一小部分真实流量上以影子模式运行,也就是先观察表现,不直接接管正式结果。
如果只是想在 Claude Code 中快速比较,可以从待办列表拿一个任务,通过 /model 分别交给两个模型,比较 /usage 报告的结果。
原文出处
https://claude.dev/blog/which-claude-model-should-you-build-with/