十大品牌
当前位置:
首页
>
排行榜
>多卡互联怎么选拓扑
多卡互联怎么选拓扑
更新时间 2026-11-19 07:57:28
多卡互联怎么选拓扑
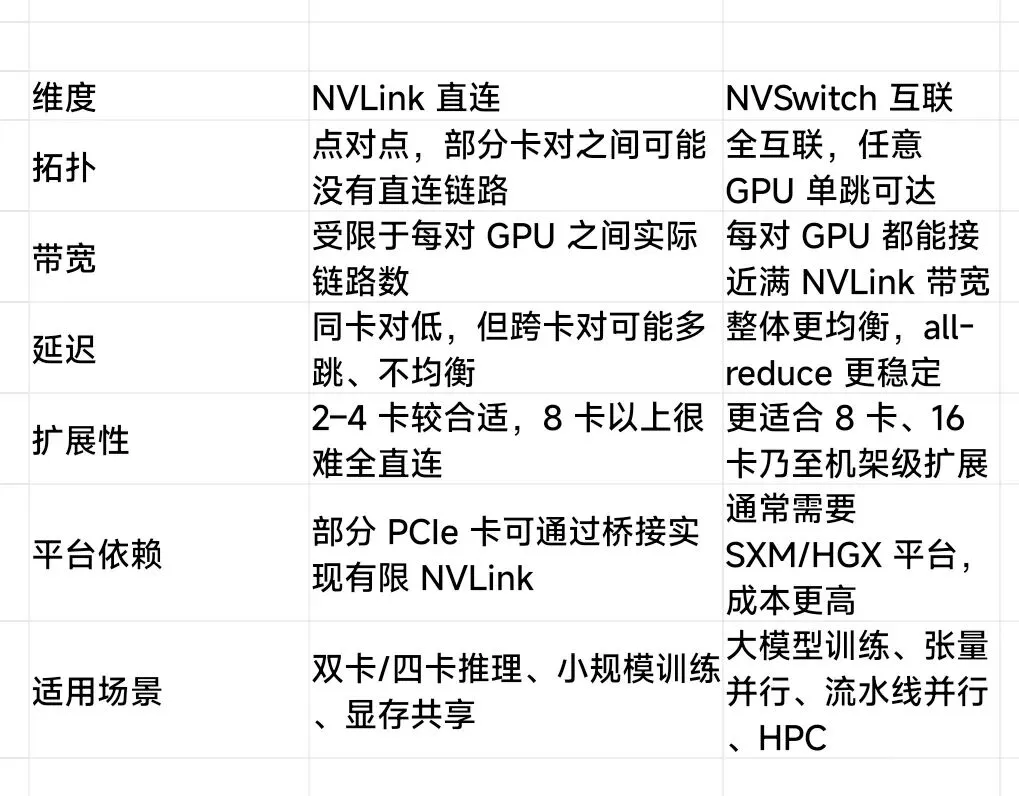
多卡互联里的“直连”和“Switch 互联”其实有两层含义。
NVLink 直连 vs NVSwitch 互联:都是 GPU 间专用高速通道,区别在于有没有交换芯片。
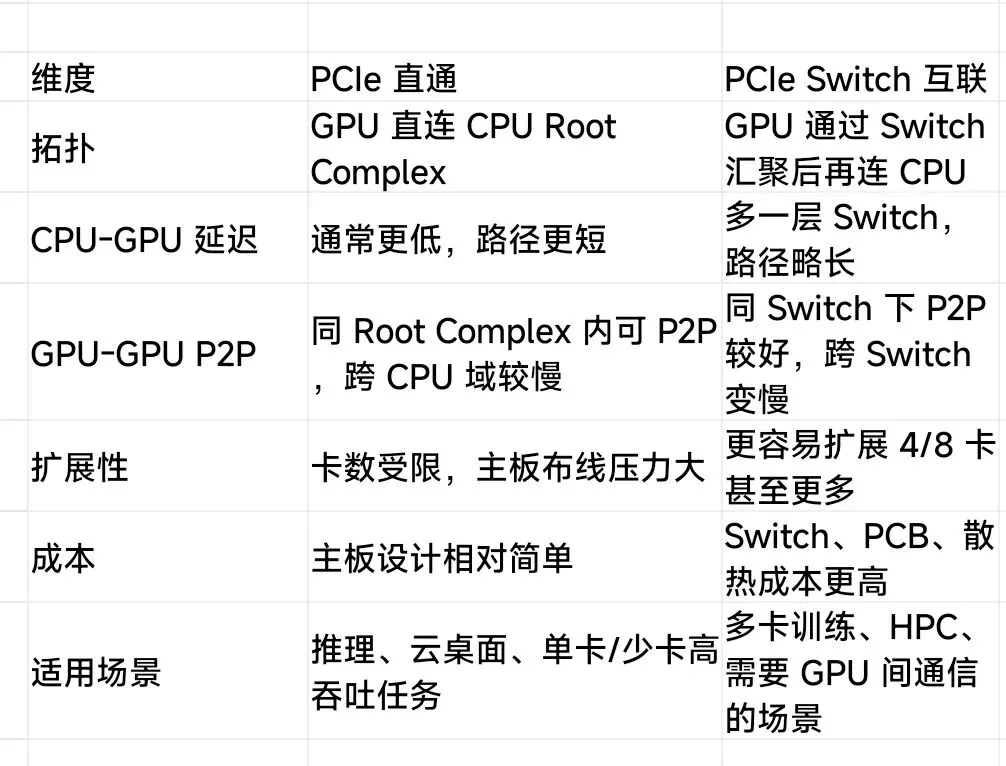
PCIe 直通 vs PCIe Switch 互联:主要影响 CPU-GPU 路径和 GPU 间 P2P 路径。
下面按这两层分别看。
NVLink 直连像“两栋楼之间修了天桥”,两点之间很快;但如果你要让 8 栋楼都互相直达,物理布线就会变得非常复杂。
NVSwitch 相当于在中间加了一个高速交换矩阵。比如 HGX H100 里 8 张 H100 通过 NVSwitch 实现全互联,任意两张卡之间都能以 NVLink 4.0 的 900 GB/s 双向带宽通信,并且支持多对 GPU 同时传输而不互相抢占。
在训练场景里,这个差别会直接反映到 all-reduce、all-gather、all-to-all 这些集合通信上。NVSwitch 拓扑下,通信路径更均衡,不容易出现“某两张卡之间特别慢,拖累整组”的情况。
PCIe 直通 vs PCIe Switch 互联
PCIe 直通在 CPU-GPU 数据加载、推理请求下发、监控采集 这类路径上通常更有优势,因为路径短、干扰少。
PCIe Switch 则更适合多卡扩展。不过要注意:PCIe Switch 下的 GPU 间 P2P 带宽仍然远低于 NVLink。PCIe 5.0 x16 双向理论约 128 GB/s,而 NVLink 4.0 单 GPU 可达 900 GB/s 双向。
实际选型建议
2 卡推理 / 小模型服务:PCIe 直通 + 有限 NVLink 直连通常够用,CPU-GPU 路径更干净。
4 卡训练 / 中等模型并行:如果支持 NVLink 直连,优先保证高频通信的卡对直连;否则 PCIe Switch 下做 P2P 也能接受。
8 卡大模型训练:优先选 NVSwitch 全互联平台,尤其是张量并行、流水线并行、MoE 专家并行这类通信密集型任务。
多节点扩展:节点内靠 NVSwitch,节点间靠 InfiniBand/RoCE;NVLink 不能跨服务器直连。
如果从硬件验证角度看,拿到一台多卡服务器后,可以先用 nvidia-smi topo -m、nccl-tests 跑 all-reduce / all-gather / all-to-all,确认 NVLink、NVSwitch 和 PCIe 拓扑是否按预期生效。很多性能问题不是卡不行,而是拓扑没对齐、通信路径绕远了。
本文来自网友投稿或网络内容, 如有侵犯您的权益请联系我们删除, 联系邮箱:wyl860211@qq.com 。
广州DSE机构怎么选?广州威学一百DSE培训班全日制 / 冲刺班 / 单科补习同步开放
天津高中住宿怎么选:能住校的学校集中在哪里,三年成本一笔账
热门文章
黄三色是哪三色颜色的?解析黄三色的具体颜色及其应用
十大平板拖把品牌排行榜_什么牌子的平板拖把好
第一次做ae视频一般多少秒,制作视频的时长建议
十大免费mp3音乐网站_mp3歌曲下载网站哪个好_MP3音乐网站大全
达泊西汀十大品牌排行榜_达泊西汀品牌排名_达泊西汀品牌排行榜
十大必看番号有哪些?你知道哪些是值得一看的热门番号吗?
亚洲尺码和欧洲尺码区别是什么
包机和专机的区别是什么?
随机文章
10个月宝宝每天需要喝多少奶粉?是否有一个标准量?
十大必看番号有哪些?你知道哪些是值得一看的热门番号吗?
宝宝喝奶粉消化不良怎么办?
Is "How do you pronounce 'formula' in English?" a Common Question for New Parents?
米诺地尔十大品牌排行榜_米诺地尔品牌排名_米诺地尔品牌排行榜
wow十大板甲幻化
用120毫升的水放几勺奶粉:你真的知道吗?
MRO工业品十大采购平台-工业品一站式采购平台排行榜
三轮车十大品牌排行榜:三轮车品牌十大排行榜:三轮车什么牌子好:2025