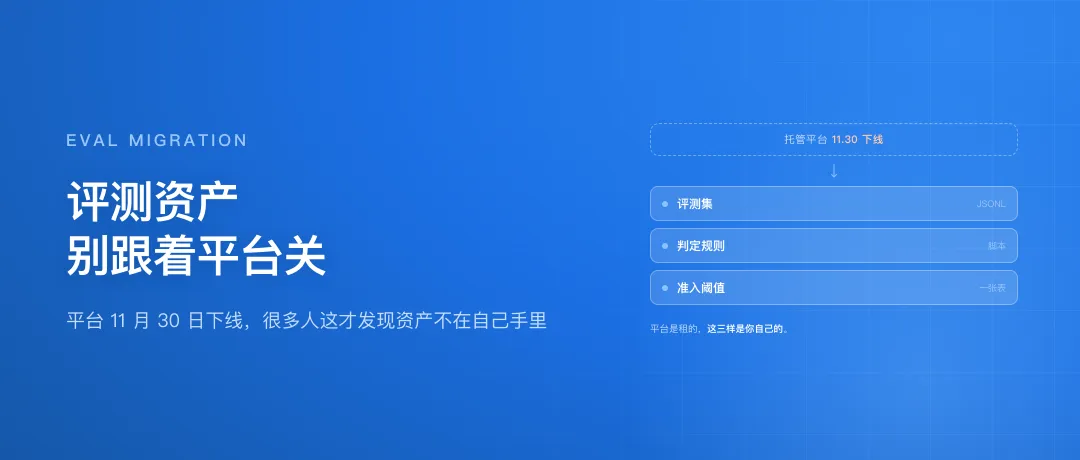
平台 11 月 30 日下线,很多人这才发现资产不在自己手里
OpenAI 的托管 Evals 平台在 2026 年 6 月宣布关停:10 月 31 日起只读,11 月 30 日仪表盘和 API 下线。同期退役的还有 Agent Builder 和 Reusable Prompts API。
消息出来之后,很多团队的第一反应是「换一个评测工具」。但真正麻烦的不是工具,是过去两年里攒在平台上的东西:评测集、判定规则、准入阈值,以及一堆只存在于仪表盘里的历史结果。
这篇文章只说一件事:评测能力不是那个托管平台,是你能带走的三类资产;平台会关,资产不该跟着消失。
一、关停时真正会丢的是什么
不是账号,也不是几行调用代码,而是三层东西:
- • 评测集。 那些人工挑出来的难例、边界样本、历史缺陷复现,往往没有第二份。
- • 判定规则。 你用提示词写的评审标准、用脚本写的断言、人工标注的口径,散在不同地方。
- • 准入阈值。 准确率低于多少不许上线、哪几类错误一票否决,这些通常只写在某个人的文档里。
工具可以换,这三样重建一次要几个月。更糟的是,很多团队直到平台只读那天,才发现自己从来没有导出过。
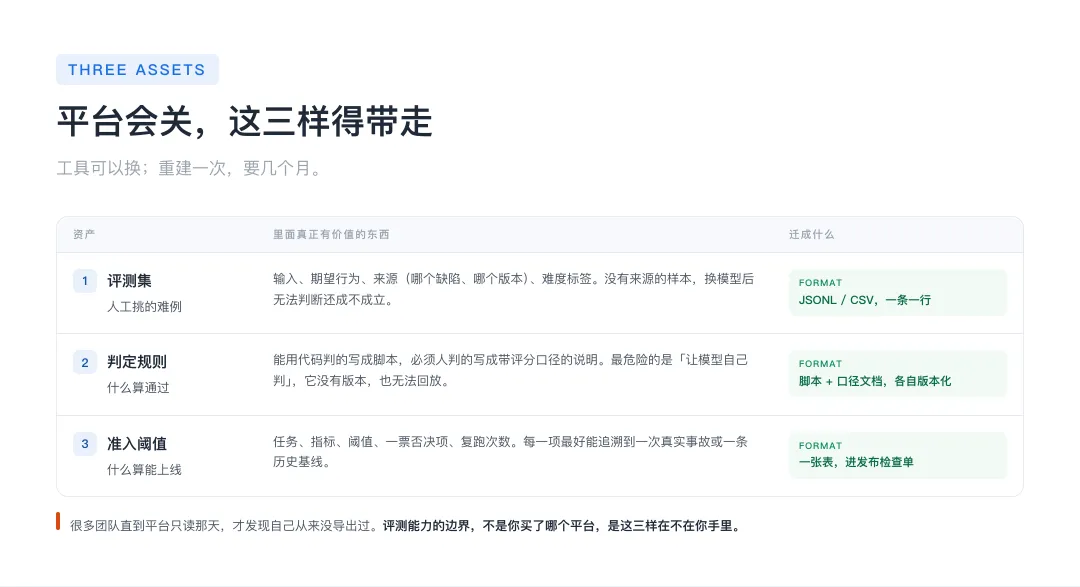
图 1:三类资产,平台会关,带得走的才是能力
二、三类资产,分别怎么带走
第一类:评测集
要带走的不只是输入输出,还有「为什么选它」。每条样本至少保留:输入、期望行为、来源(哪个缺陷、哪个版本)、难度标签。没有来源的样本,换一个模型之后就无法判断它还成不成立。
导出格式越朴素越好:JSONL 或 CSV,一条一行,不要依赖某个平台的嵌套结构。
第二类:判定规则
把判定拆成两类:能用代码判的,和必须人判的。能用代码判的,写成独立脚本,输入是模型输出,输出是通过或不通过;必须人判的,写成一份带评分口径的说明,确保换一个人也能给出接近的结论。
最危险的是「让模型自己判」的规则:它没有版本,也没有办法回放。迁移时至少固定模型和提示词版本,并把每次判定结果留下来。
第三类:准入阈值
把「什么算通过」写成一张表:任务、指标、阈值、一票否决项、复跑次数。阈值不是拍脑袋定的,最好能追溯到一次真实事故或一次历史基线。
这张表的价值在于:换平台、换模型、换人,判断标准不变。
三、迁移的顺序
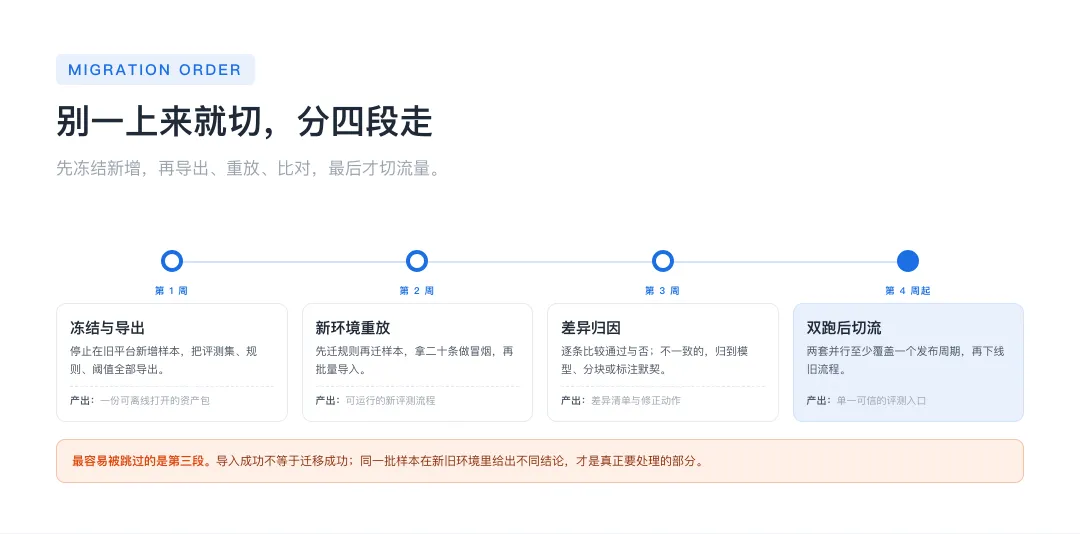
不要一上来就切。先用一周冻结新增,把现有资产导出;再用一周在本地或新平台上重放,比较结果差异;差异大的样本单独标出来,通常是判定规则依赖了平台特性;最后再切流量。
迁移期间两套并行跑,至少覆盖一个完整发布周期。旧平台的仪表盘会关,但历史结果能截图的先截图,能导出的先导出,别等到最后一天。
一个常见的失败迁法是:把平台导出的嵌套 JSON 原样喂给新平台,导入成功,跑出来却全是失败。原因不是新平台差,是判定规则里写着「用平台默认评审模型打分」,换一个模型,分数分布就变了。数据迁过去了,判定口径没迁过去。
所以迁移验收要看的不是「导入成功」,而是「同一批样本,在新环境里的通过或不通过,和旧环境一致」。不一致的样本逐条看,通常能归到三类:依赖了旧平台的模型、依赖了旧平台的分块方式、依赖了人工标注里没写下来的默契。前两类可以改规则,第三类只能重新标注。
还有一个省力的顺序:先迁判定规则,再迁评测集。规则是解释器,样本是数据;解释器不对,数据导进去也只是多了一堆跑不动的用例。规则迁好后,先拿二十条样本做冒烟,确认通过和不通过都对得上,再批量导入。
评测集和规则都要跟代码一样进版本库:每次修改留一个提交,写清为什么改、改了哪条样本。没有版本,三个月后没人说得清某个阈值是怎么来的,也没人敢动它。历史结果则要留可回放的最小集:不是截一张仪表盘图,而是保留输入、输出、判定结果三件套。截图能证明「当时是这样」,不能证明「为什么是这样」。
图 2:迁移分四段,重放比对不能省
四、边界:有些东西迁不走
托管平台的人工标注队列、协作评论、可视化报表,很难一比一复制。这些不是评测能力本身,是协作层。迁移时接受损失,别为了复刻一个仪表盘再绑死到下一个平台。
另一个边界是成本:重放全部评测集可能很贵。先迁高风险的那部分,长尾样本可以按季度补。
五、可照做清单
- 1. 列出当前评测集、判定规则、阈值分别存在哪,标出只在平台里的部分。
- 2. 在 11 月 30 日前导出评测集,保留来源和难度标签。
- 3. 把判定规则拆成代码判定和人工判定两类,各自版本化。
- 4. 在新环境重放一批样本,记录与旧平台的差异,不要假设结果一致。
- 5. 迁移后保留一个完整发布周期的双跑,再下线旧流程。
在平台上,对应的做法很朴素:评测集放回自己的用例库,跟着版本走;判定规则跟用例一起存;阈值写进发布检查单。工具会换,这三样留在自己手里,下一次换平台就不用再重来一遍。
如果你们的评测资产还锁在某个托管平台上,把这篇转给负责迁移的那个人。