【智能体-科学发现-评测基准】Autonomous Science Bench:面向自主科学发现AI智能体的基准
- 更新时间 2026-11-18 07:48:48
Autonomous Science Bench:面向自主科学发现AI智能体的评测基准
摘要
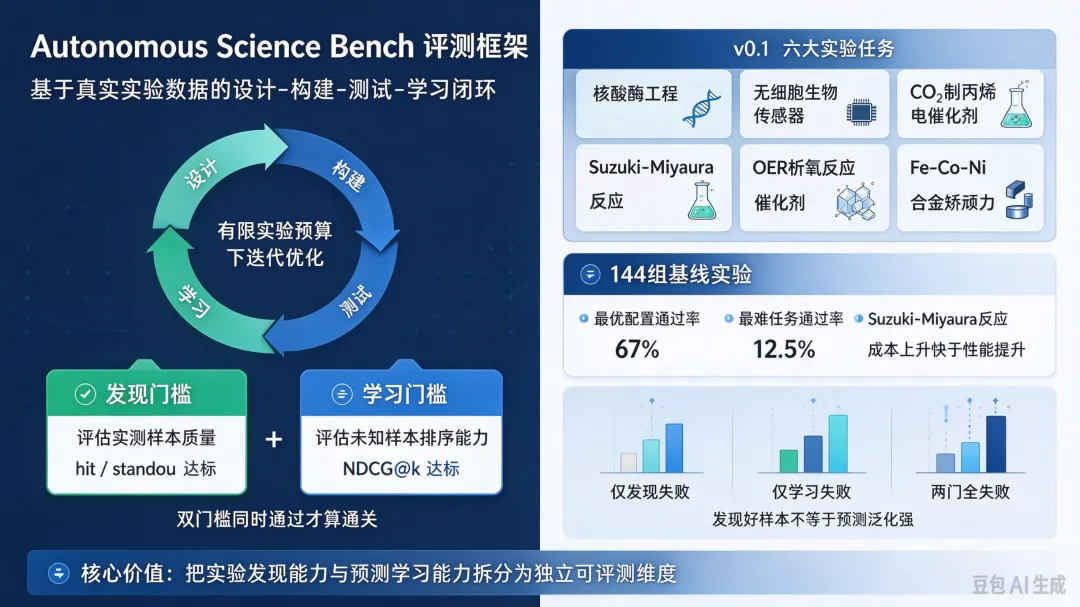
现有的面向科学 AI 智能体的评测基准大多使用固定数据集;支持主动实验的基准多数依赖仿真环境。本文提出Autonomous Science Bench,该基准 v0.1 版本包含 6 个基于已发表真实实验构建的「设计‑构建‑测试‑学习(DBTL)」闭环实验任务,覆盖生物学、化学、材料科学三大领域。
智能体在有限实验预算下分批次选择待测试设计,从实验室服务获取测量结果,迭代指导后续实验,最终输出预测模型。评测设置两道独立校验门槛:\\ 发现门槛(discovery gate)\\ 评估智能体实际测出的实验样本质量;\\ 学习门槛(learning gate)\\ 评估模型对未见过样本的排序预测能力,任务必须两道门槛全部通过才算成功。
研究开展 144 组实验,测试 8 种智能体‑模型组合。最优配置整体通过率 67%;最难任务仅 24 次尝试中成功 3 次。两道评测门槛可以暴露单一总成功率掩盖的缺陷:部分智能体能够发现优质样本,但泛化预测能力差;另一部分预测模型效果好,但没有找到足够多有价值的实验样本。本项目开源全部任务、实验室运行环境与公开排行榜。
1 引言
自主科学发现 AI 智能体需要迭代选择实验,利用已有实验结果规划下一轮测试。自动驾驶实验室把模型、自动化设备、测量环节整合为闭环工作流;大语言模型驱动的 AI 智能体已经可以完成化学实验规划、全链路科研流程。
智能体核心能力:在有限预算中判断哪些实验值得执行,平衡探索与利用,根据实验证据更新实验方案。
现有科学智能体基准局限:
1.很多基准只评估智能体在给定静态数据集上的问答、数据分析能力,不支持交互式实验选择;
2.少量闭环基准支持按预算顺序请求测量,但大多使用仿真数据;很少把 “发现样本” 和 “学习预测模型” 两项能力分开评估。
核心论点:两项能力不能互相替代。智能体有可能找到优质实验样本,但对未知样本预测很差;也可以学到性能优秀的预测模型,但没挖掘出足够多的有效候选。
本文主要贡献
1.以完整实验任务(campaign)作为评测单元:评测受预算约束的 DBTL 闭环,实验室服务管控预算,完整记录每一次实验;
2.双门槛联合评测机制:分别衡量智能体实验发现能力、模型学习泛化能力,暴露总成功率掩盖的能力短板;
3.6 个基于真实已发表实验的任务:覆盖生物、化学、材料;开源任务、运行时、校验器与排行榜;144 次基线实验证明现有智能体可靠性不足;
4.面向真实物理实验室的自适应预算调度器:对能力更强、信息增益更高的智能体优先分配稀缺实验资源。
2 Autonomous Science Bench 基准设计
整套基准遵循 Harbor 任务框架,包含有状态的虚拟实验室服务,以及发现、学习两道独立评测门槛。
2.1 六大实验任务总览(v0.1)
共 6 项任务,生物、化学、材料各 2 个,全部基于公开文献实验数据。
生物学 | 化学 | 材料科学 | ||||
Nuclease 核酸酶工程 | 无细胞生物传感器 | CO₂制丙烯电催化剂 | Suzuki‑Miyaura 反应条件筛选 | OER 析氧反应催化剂 | Fe‑Co‑Ni 合金矫顽力 | |
数据源 | Thomas et al. (2025) | Wang et al. (2025a) | Kim et al. (2025) | Perera et al. (2018) | Rohr et al. (2020) | Wang et al. (2022) |
后端模式 | replay 回放 | replay 回放 | twin 数字孪生 | replay 回放 | replay 回放 | replay 回放 |
轮次 × 每轮批量 | 4 × 96 | 3 × 10 | 3 × 20 | 4 × 48 | 4 × 48 | 4 × 16 |
候选总池大小 | 20000 | 677 | 736 | 2764 | 3419 | 604 |
预算占总池比例 | 1.9% | 4.4% | 8.2% | 6.9% | 5.6% | 10.6% |
合格候选数量 | 3954 | 58 | 14 | 168 | 288 | 20 |
评估集大小 | 5000 | 332 | 244 | 1844 | 5039 | 307 |
发现门槛指标 | hits≥190;家族≥175 | 选择性命中≥21 | hits≥7 | 突出样本≥32 | 突出样本≥55;单库上限 28 | 峰值得分≥0.60 |
学习门槛指标 | NDCG@100 ≥0.42 | NDCG@20 ≥0.70 | NDCG@20 ≥0.52 | NDCG@100 ≥0.37 | NDCG@100 ≥0.55 | NDCG@20 ≥0.65 |
领域专家耗时 | 10 h | 8 h | 10 h | 10 h | 12 h | 8 h |
表 1:v0.1 六个任务参数表 |
•预算最多仅覆盖候选池 11%;仅均匀采样不足以通关;
•各任务科学难点:
a.核酸酶:需要命中大量且多样性的变体;
b.生物传感器:有限预算定位高选择性变体;
c.丙烯电催化:稀有有效样本挖掘;
d.Suzuki 反应:跨底物对比反应条件;
e.OER 催化剂:对不可测量的四阳离子区域做预测;
f.矫顽力:需要同时搜索两个互不相连性能峰值。
2.2 任务数学定义
任务元组: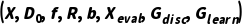
• :可以申请测量的全部设计池;
• :初始种子数据集,是已经测量好的少量样本,作为智能体起点;
• :真实响应函数,对智能体完全隐藏,保存在实验室服务;
• 实验轮数;
 每轮批量大小;总预算
 ;每一个样本只允许测量一次;
•每一轮智能体提交一批未测样本 ,实验室返回测量结果
 ;
• :不可申请测量的 held‑out 评估集,仅校验器可以访问真实标签;
•任务通关条件: 发现门槛、
 学习门槛两者全部通过。
实验结束智能体需要提交独立 JavaScript 预测函数predict(design);校验器在沙盒隔离环境运行,禁止访问网络、文件、随机数。
每个任务附带参考解决方案,采用领域科学家常规策略,用来校验基准合理性;单任务智能体时间上限 8 小时。
2.3 Lab Service 实验室服务
统一 Lab API v1,智能体通过命令行客户端asb访问。
1.账本机制:实验室拥有实验记录唯一权威账本;强制轮次顺序、批量大小,禁止重复测量;拒绝无效请求不消耗预算;账本智能体不可篡改;实验结束账本与提交模型交给校验器打分。
2.三种后端:
后端 | 数据来源 | 现状 |
Replay 回放 | 存储已发表真实实验测量值 | 5 个任务使用 |
Twin 数字孪生 | 隐藏代理模型仿真输出 | 丙烯催化任务使用 |
Live 真实实验室 | 物理自动化实验室测量 | 接口已定义,v0.1 未启用 |
2.4 两道评测门槛
(1)发现门槛 Discovery gate
统计所有已经完成测量样本的真实性能,和校准阈值对比。
•hit 命中:达到科学定义性能阈值的样本;
•standout 突出样本:分组内排名靠前的优质样本。
(2)学习门槛 Learning gate
采用 NDCG@k 衡量模型对不可见评估集的排序能力: 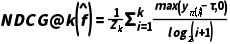
• :模型预测分数降序排列;
• :样本真实性能;
 任务特定阈值;
• 归一化系数,完美排序 NDCG=1。
为什么必须设置两道门槛:二者没有必然等价关系 |
1.只过发现门槛:找到好样本,但无法泛化预测未知样本;
2.只过学习门槛:模型排序性能好,但没有在预算内测出足够多高质量实验样本。
部分策略只能单独通过其中一道门,参考解可以全部通关。
任务 | 仅单门通过的策略 | 归一化分数(发现 / 学习) | 参考解分数(发现 / 学习) |
Biosensor 生物传感器 | 目录统计,完全不利用测量结果 | 1.10 / 0.70 | 1.14 /1.16 |
Suzuki 反应 | oracle 挑选 192 个样本,基线预测器 | 2.28 /0.86 | 1.19 /1.18 |
Propylene 丙烯催化 | 原文贝叶斯优化流程 | 0.57 /1.07 | 1.14 /1.20 |
Coercivity 矫顽力 | 缺铁区域空间填充采样 | 0.54 /1.13 | 1.54 /1.27 |
表 2:单门不足以评估任务,部分策略只能通过其中一个门槛 |
2.5 任务构建与捷径审计
所有任务来源于已发表实验,执行严格审计:检查数据质量、授权许可,规避捷径(shortcut)。
•规避捷径手段:扩大设计空间;评估集从早期库抽取;对聚类的性能峰值要求多区域覆盖;屏蔽论文中泄露的提示信息;
•校准四条硬性标准:
a.参考解通关至少留有 10% 性能余量;
b.非自适应基线、零测量预测器 90% 以上拆分下失败;
c.发现门槛不需要超过池子里一半合格样本;
d.NDCG 评估集合保留足够多有效样本。
执行捷径审计:空操作智能体必须得 0 分;零测量预测器不能通关学习门槛。
3 实验设置
•智能体‑模型配置共 8 组:Claude Code 系列(Opus5.5、Sonnet5.5、Haiku4.5)、Codex 驱动 GPT‑5.6 Terra / Luna;开源模型 Qwen3.8‑27B、MiniMax M3、GLM‑5.3‑Flash,基于 mini‑SWE‑agent 框架。
•运行框架 Harbor 0.21.0;每个任务 8 小时时间上限。
•总实验:8 配置 × 6 任务 ×3 次重复 =144 次完整 trial
•指标:Resolution rate 通过率:两道门槛全部通过的试次占比;同时统计 token 消耗、运行时间、API 成本。
4 实验结果
4.1 模型性能与成本
•全部 144 次 trial 均完成轮次并输出格式合法模型;
•Opus5.5(Claude Code)通过率67%;GPT‑5.6 Terra 44%;GPT‑5.6 Luna 28%;开源模型整体表现弱;Haiku4.5 零成功。
•任务难度差异:OER 最容易(24 次 8 次成功);矫顽力最难(24 次仅 3 次成功)。
•成本陡峭上升:从 GPT‑5.6 Luna 到 Opus5.5,总成本扩大 25 倍,但通过率仅提升 2.4 倍;每成功一次实验的成本大幅增加。
模型 | 核酸酶 | 生物传感器 | 丙烯 | Suzuki | OER | 矫顽力 | 通过率 | 总成本 (USD) | 总时间 h |
Opus5.5 | 3/3 | 0/3 | 2/3 | 2/3 | 3/3 | 2/3 | 67% | 172.90 | 19.0 |
GPT‑5.6 Terra | 0/3 | 2/3 | 1/3 | 2/3 | 3/3 | 0/3 | 44% | 51.57 | 5.0 |
GPT‑5.6 Luna | 1/3 | 2/3 | 1/3 | 1/3 | 0/3 | 0/3 | 28% | 6.91 | 6.3 |
Sonnet5.5 | 0/3 | 0/3 | 1/3 | 0/3 | 1/3 | 0/3 | 11% | 7.85 | 2.7 |
GLM‑5.3 Flash | 0/3 | 0/3 | 0/3 | 0/3 | 1/3 | 1/3 | 11% | 25.69 | 28.4 |
Qwen3.8‑27B | 0/3 | 0/3 | 0/3 | 1/3 | 0/3 | 0/3 | 6% | 21.89 | 18.6 |
MiniMax M3 | 1/3 | 0/3 | 0/3 | 0/3 | 0/3 | 0/3 | 6% | 28.37 | 12.5 |
Haiku4.5 | 0/3 | 0/3 | 0/3 | 0/3 | 0/3 | 0/3 | 0% | 7.62 | 1.5 |
表 3:各模型在 6 个任务的成功次数(3 次重复)、通过率、开销 |
4.2 失败模式:区分发现失败与学习失败
113 次未通关试次的失败分类:
任务 | 仅发现失败 | 仅学习失败 | 两门全部失败 | 总失败次数 |
Nuclease 核酸酶 | 4 | 0 | 15 | 19 |
Biosensor 生物传感器 | 12 | 0 | 8 | 20 |
Propylene 丙烯催化 | 1 | 16 | 2 | 19 |
Suzuki 反应 | 5 | 2 | 11 | 18 |
OER 析氧 | 0 | 12 | 4 | 16 |
Coercivity 矫顽力 | 3 | 0 | 18 | 21 |
合计 | 25 | 30 | 58 | 113 |
表 4:失败模式统计,接近一半失败试次可以通过其中一道门槛,仅看总成功率会掩盖差异。 |
不同任务失败模式完全不同:
•丙烯催化:大多能找到足够 hit,但是预测模型 NDCG 不达标(仅学习失败);
•生物传感器:模型预测能力尚可,但找不到足够选择性 hit(仅发现失败);
•OER:评估集完全不可测量,大量试次仅学习失败;
•矫顽力:既要搜索两个峰值,大量试次两门同时失败。
智能体能力分化: Sonnet5.5 经常学习门槛得分很高,但是发现样本多样性不足;GPT‑5.6 Luna 可以找到好样本,但是预测泛化弱;所有试次归一化发现、学习得分 Spearman 相关系数仅 0.43,二者存在相关性但可以解耦。
4.3 预算使用行为
账本可以分析每一轮智能体选择样本的 hit 率:
1.即使未通关的智能体,第二轮 hit 率也显著高于随机采样;但是很多无法满足多样性、多区域覆盖要求,依旧不能过发现门槛;
2.任务行为差异:
○Biosensor:通关试次第一轮就高命中率;失败试次直到最后一轮才出现高 hit,预算耗尽来不及积累;
○Propylene:成功 / 失败试次 hit 率差距不大,胜负取决于最终模型学习质量;
○Coercivity:通关试次大多在后两轮找到第二个性能峰值。
5 面向真实物理实验室:自适应预算调度算法
真实物理实验室测量成本昂贵,无法对全部智能体分配完整预算。本文提出自适应调度器,根据中间实验结果动态分配每一轮测量配额。
核心逻辑:
1.维护每个智能体在任务上通关概率 贝叶斯后验;结合回放基准数据与实时部分实验历史;
2.两阶段分配:
○第一阶段:对预估通过率高于阈值 的智能体优先分配完整批量配额;
○第二阶段:剩余资源分配给可以最大化区分智能体能力的试次,降低选择遗憾(knowledge‑gradient 思想)。
3.每一轮结束更新全部智能体后验估计;允许部分智能体本轮获得 0 测量配额。
伪代码见 Algorithm1、Algorithm2;该调度器为 live 后端设计,v0.1 版本没有做实验验证。
6 局限性
1.规模有限:v0.1 仅 6 个任务,8 个模型配置;后续计划扩充任务领域,开放社区贡献;
2.回放、数字孪生仿真不等于真实物理实验,设计空间受原有数据集限制;
3.公开数据集存在被大模型记忆风险;eegress 网络控制不能保证 100% 阻断;未来 live 物理实验室后端可以规避。
7 结论
自主科学 AI 智能体核心挑战:在有限资源下决定做哪些实验。Autonomous Science Bench 基于真实已发表实验构建闭环 DBTL 评测任务。
双门槛的核心价值:把 “发现高质量实验样本”、“学习泛化预测模型” 拆分为两项独立指标。现有前沿模型仍然存在短板,部分智能体擅长发现、部分擅长预测,单纯总成功率无法体现。
开源全部任务、运行环境、校验器、排行榜。未来从回放仿真、数字孪生逐步迁移到真实自动驾驶物理实验室;配套自适应调度器,高效利用珍贵的真实实验资源。
核心图表展示
图 3 不同配置的失败类型、性能‑成本曲线
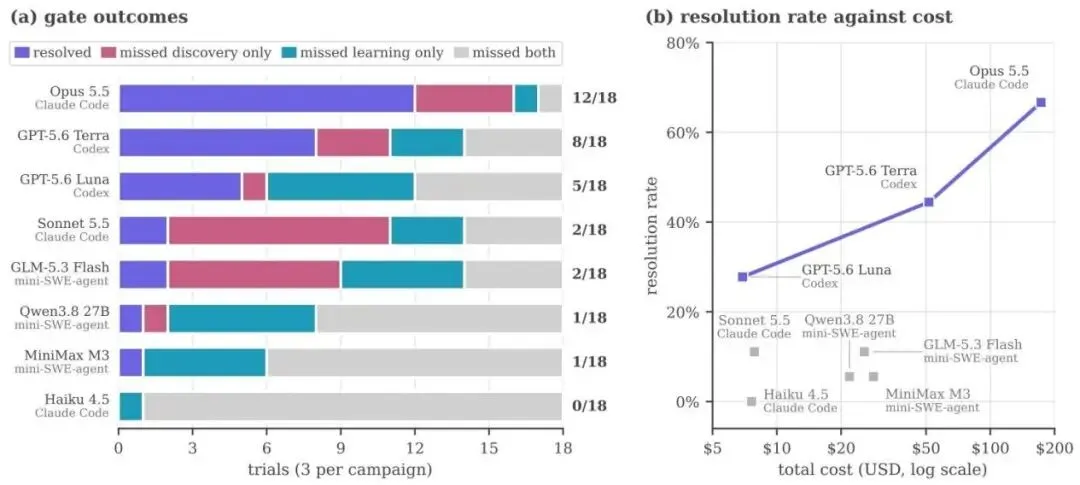
(a) 各模型 18 次 trial 的结果统计:绿色全部通关;红色仅发现失败;蓝色仅学习失败;灰色两门都失败。 (b) 通过率‑总模型成本帕累托前沿;性能越高的模型,成本急剧上升。
图 6 全部校准基线策略归一化得分
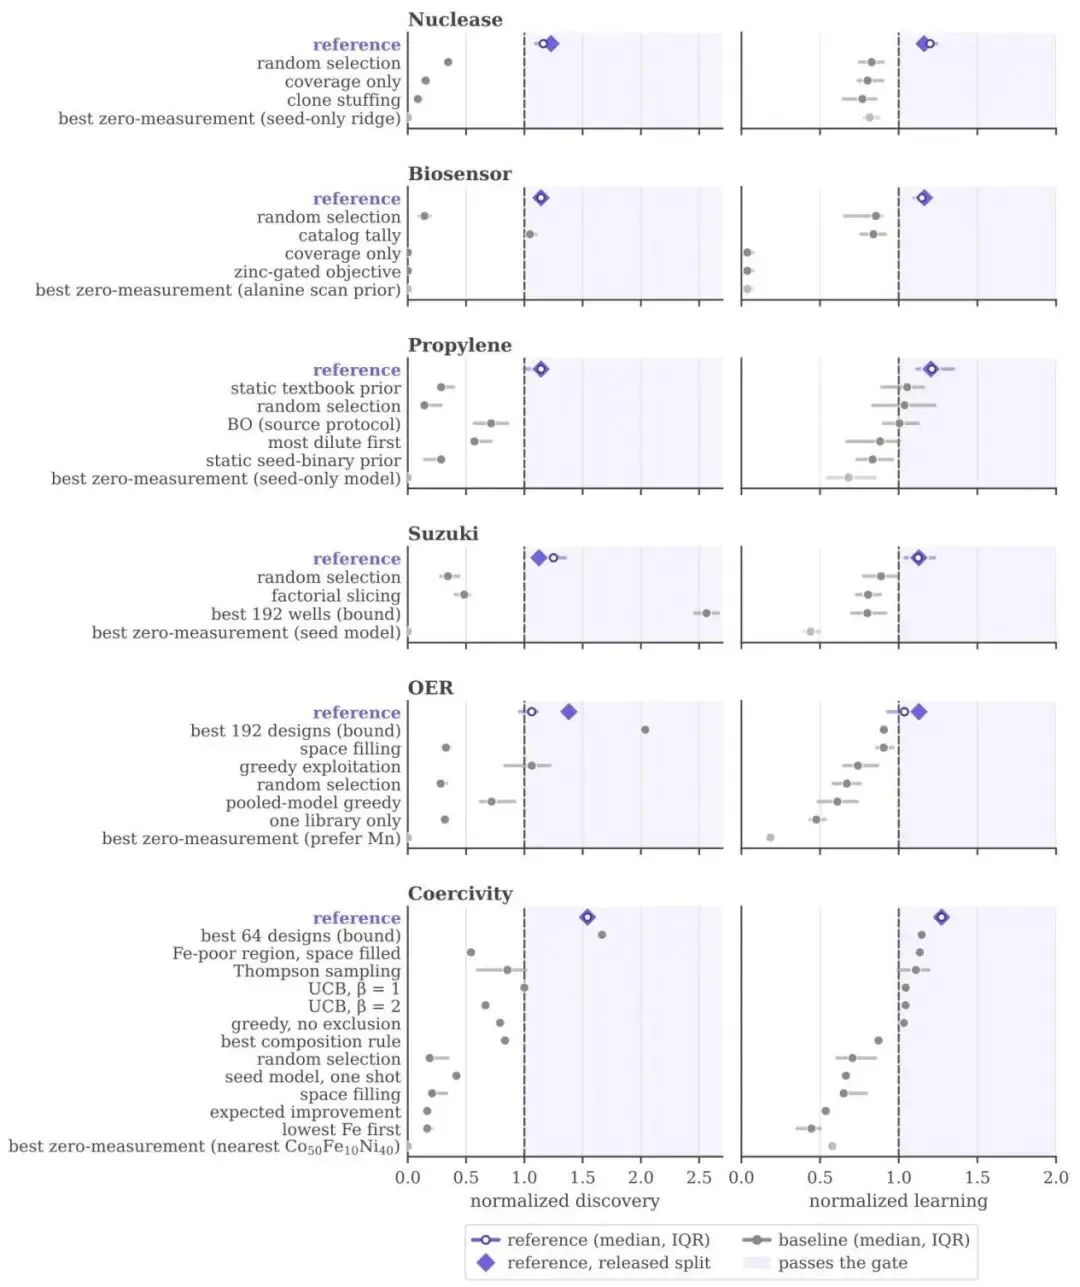
每个子图对应一个任务;横坐标归一化发现得分,纵坐标归一化学习得分;菱形为参考解在发布拆分的得分;灰色 IQR 区间是各类基线策略(随机采样、空间填充、零测量先验、论文原始 BO 策略等)。白色区域代表同时通过两道门槛。可以直观看到绝大多数基线策略只能通过单门或者全部失败。
附录要点
1.相关工作
○Terminal‑Bench 系列:在容器终端评估科研工作流,但数据全部预先提供,没有实验申请闭环;
○其他科学智能体基准:多数是静态数据集问答分析;少数闭环基准基于完全合成仿真;
○闭环实验优化基准如 Olympus、BoxingGym、MADE,要么只评测优化获取点,不评测交付预测模型;或者是专用优化策略,不是通用编码智能体。 本基准独特之处:面向通用编码智能体;双独立校验门槛;测量来源于真实已发表实验数据。
2.每个任务完整卡片 C.1‑C.6:详细描述科学背景、容易被利用的捷径、如何在基准中封堵捷径;
3.Lab API 接口、账本 JSON 格式;
4.详细校准规则、捷径审计流程;
5.模型完整标识符、智能体版本;
6.自适应调度器完整算法、平滑公式、结果模型训练思路。
开源地址
•项目网页:https://yibow.me/autonomous‑science‑bench
•GitHub:https://github.com/Yibo‑Wen/as‑bench
•arXiv 编号:2610.18449
注:本总结完整保留论文核心概念、全部关键表格、两张核心图片,梳理清楚基准设计逻辑、实验结果、调度算法、局限性。 |
生物智能:在生物先进产业场景中构建“状态感知-实时认知-自主决策-精准执行-学习提升”的生物科学智能(NeuroAI);实现生物产业转型升级、DT驱动业务、价值创新创造的产业互联生态链。
生物产业+物理AI=生物智能
产业智能官:NeuroAI
加入知识星球“生物智能研究院”:自动化生物铸造厂OT技术(自动化+机器人+工艺+精益)和新一代IT技术(云计算+物联网+区块链+大数据+人工智能)深度融合,在场景中构建“状态感知-实时认知-自主决策-精准执行-学习提升”的生物科学智能(NeuroAI);实现产业转型升级、DT驱动业务、价值创新创造的产业互联生态链。
版权声明:产业智能官(ID:NeuroAI)发表的文章,除非确实无法确认,我们都会注明作者和来源,涉权请联系协商解决,联系、投稿邮箱:wolongzy@qq.com
