打卡 42 | DNA 模型及其评测任务;AG2 / NT / GENERator 系与 tokenization;想到--存活即自回归采样
接连两个周末一整周每日被老师拉上线讨论 rebuttal 之后,今天早上总算回复完了几个审稿人wwww!!虽然最后的版本几乎是被老师又重整了一遍...;不愧是老师啊(感觉总是很高级了...... ><):
---
继续回到 long-horizon!!!
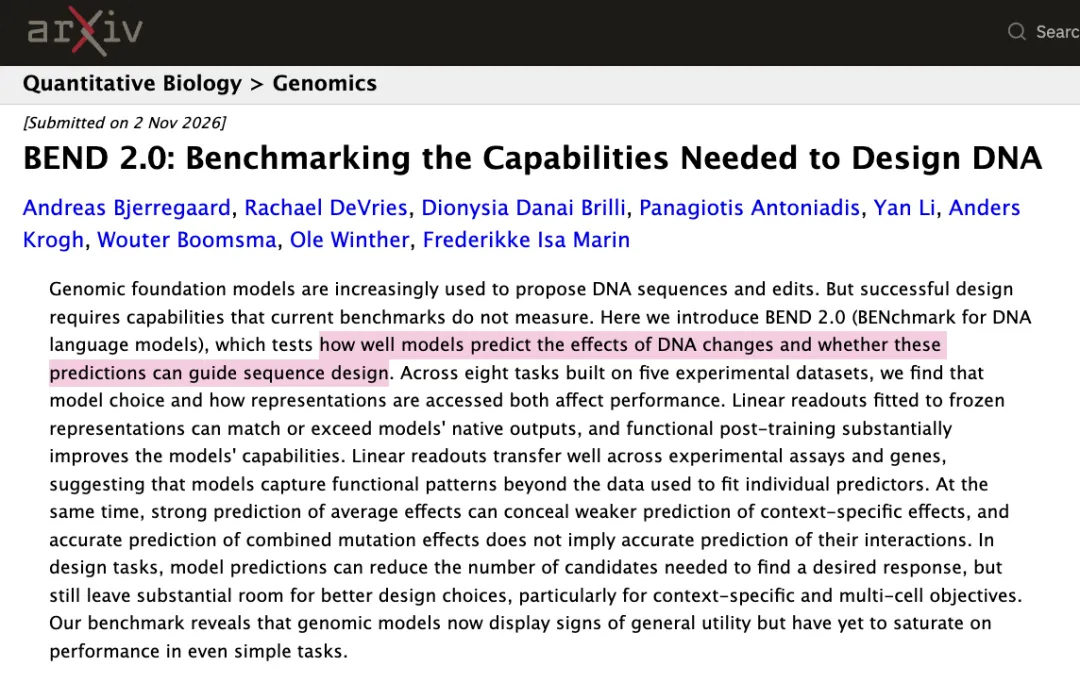
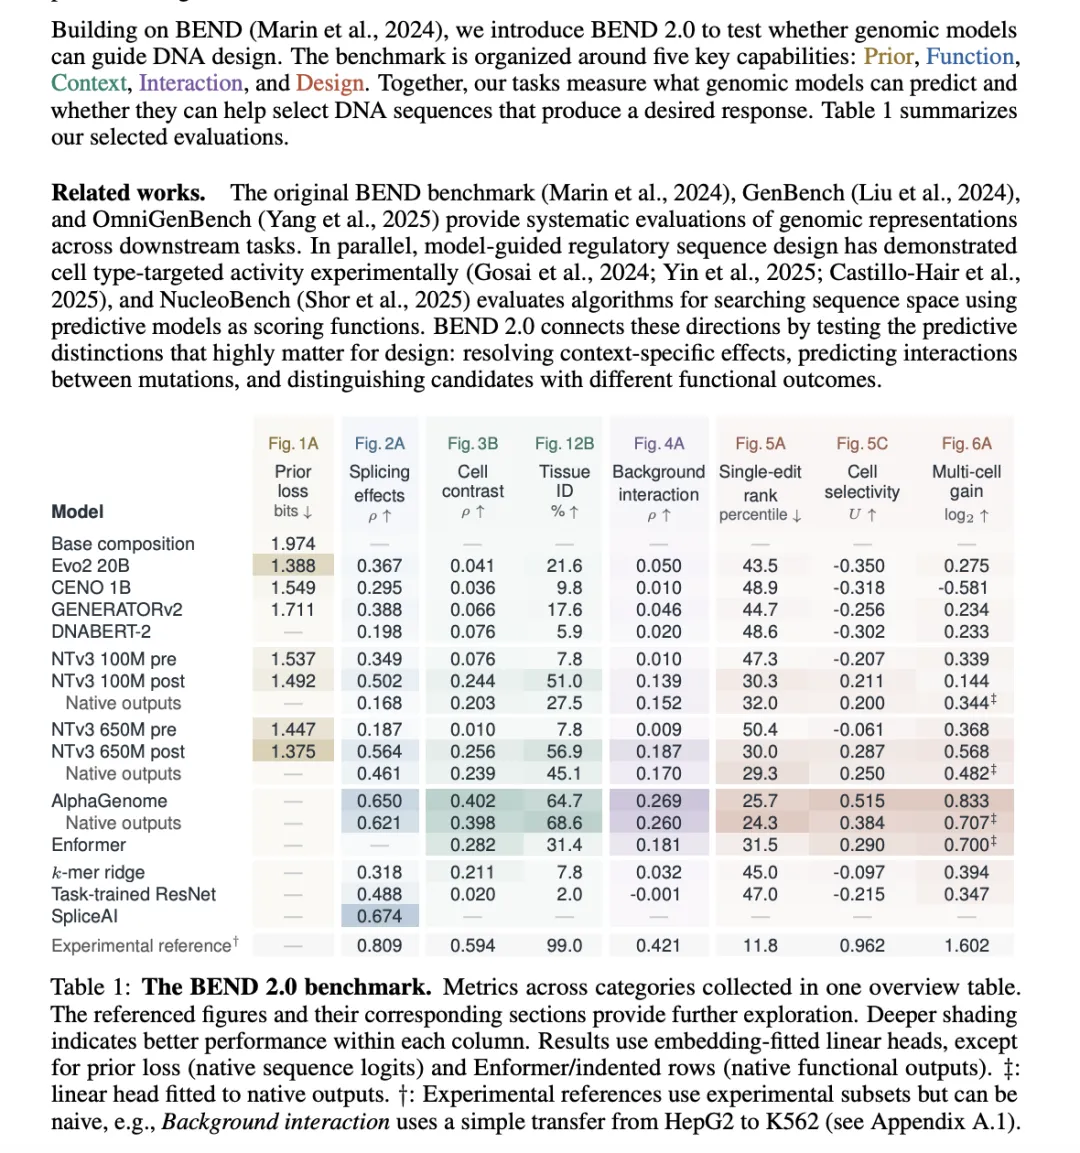
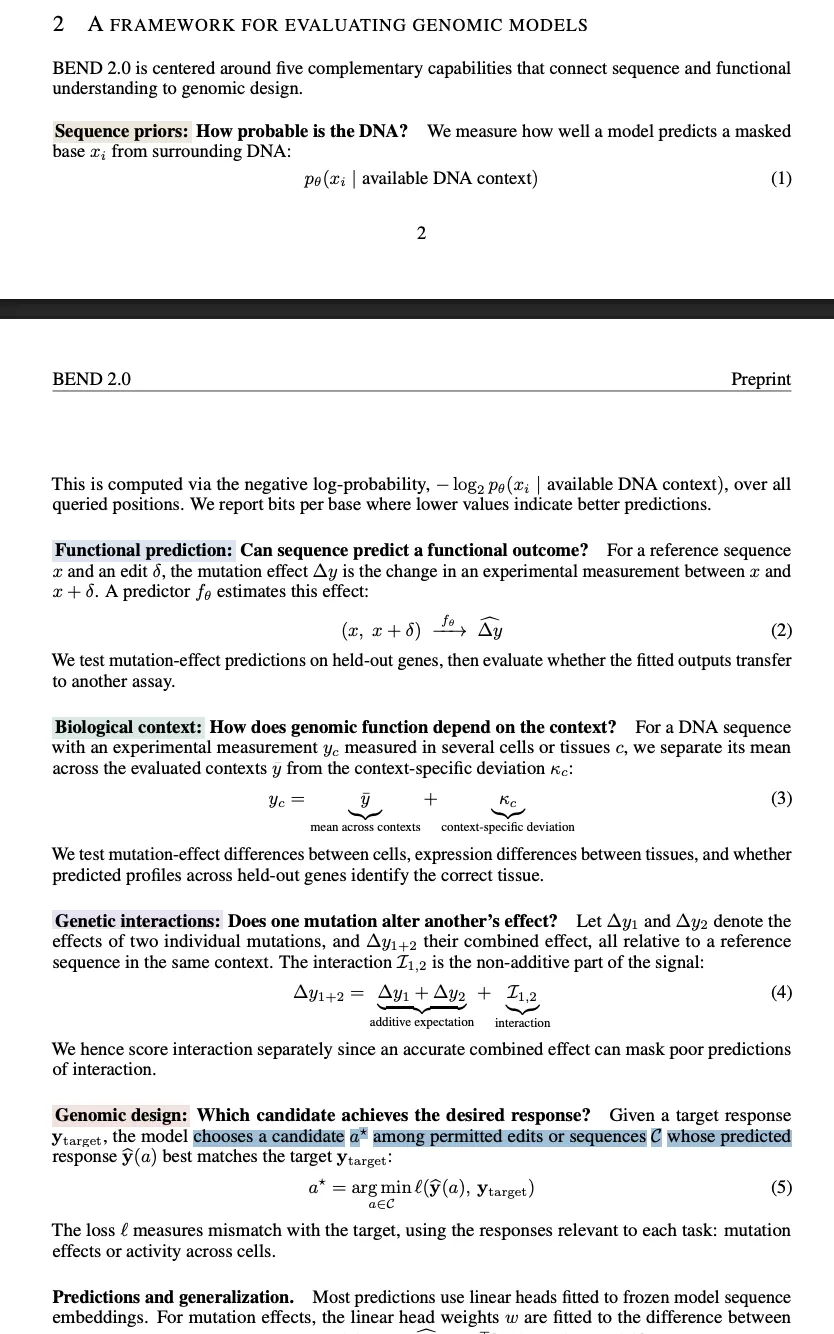
周末读了一下 DNA 序列模型相关的评测任务。发现哪怕是称作 generative tasks 的评估,哪怕是这么新的 preprint(本月初诶!),实际上也还是比打分那一类的,而不太是评测真正的生成。
(嘿,但你可是叫作 "genomic models" 啊!)---
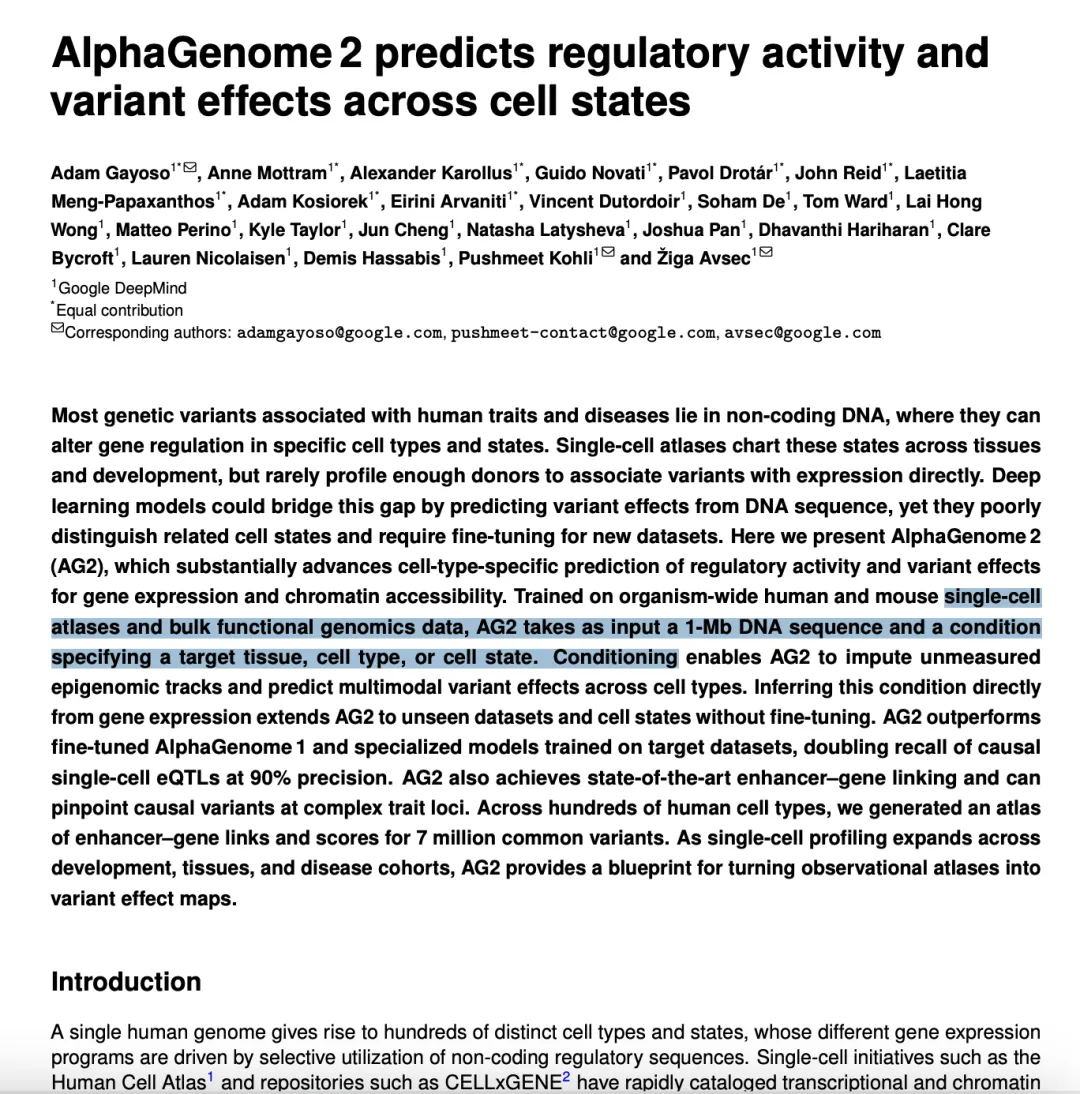
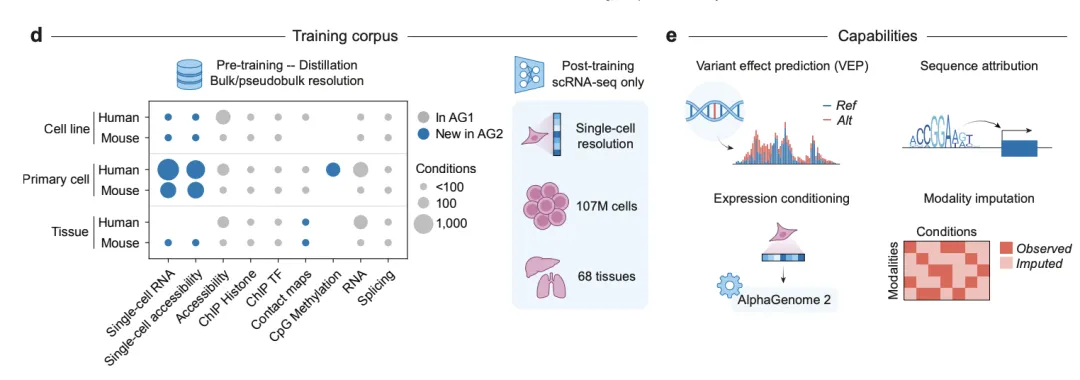
AG2 最近好火呀,也跟风去看了一下。接收 ~1 million bp DNA 输入,但这一版主要强调预测不同细胞状态(!)下的 conditioning 和单细胞数据上训。
但可能关系没有那么大,毕竟并非做生成任务,所以也没有仔细去看。同理,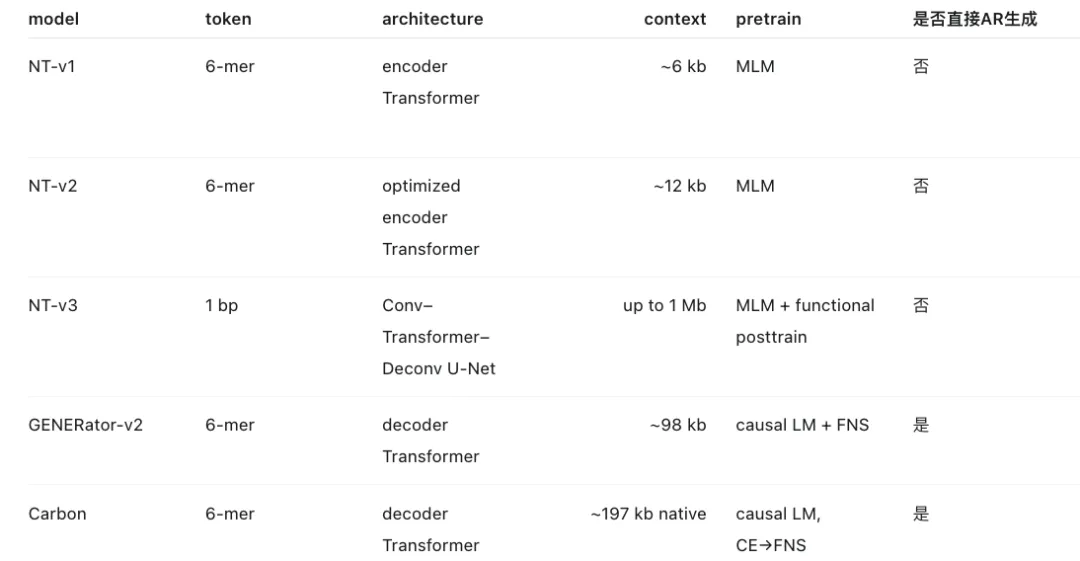
---
其实是上周五参加联合组会,被老师问到 GENERATor 系列被问住,一旁师兄打了圆场555;感到自己很疏忽,组会上慌乱回应老师的时候还说错了,,,。
...严肃学习!
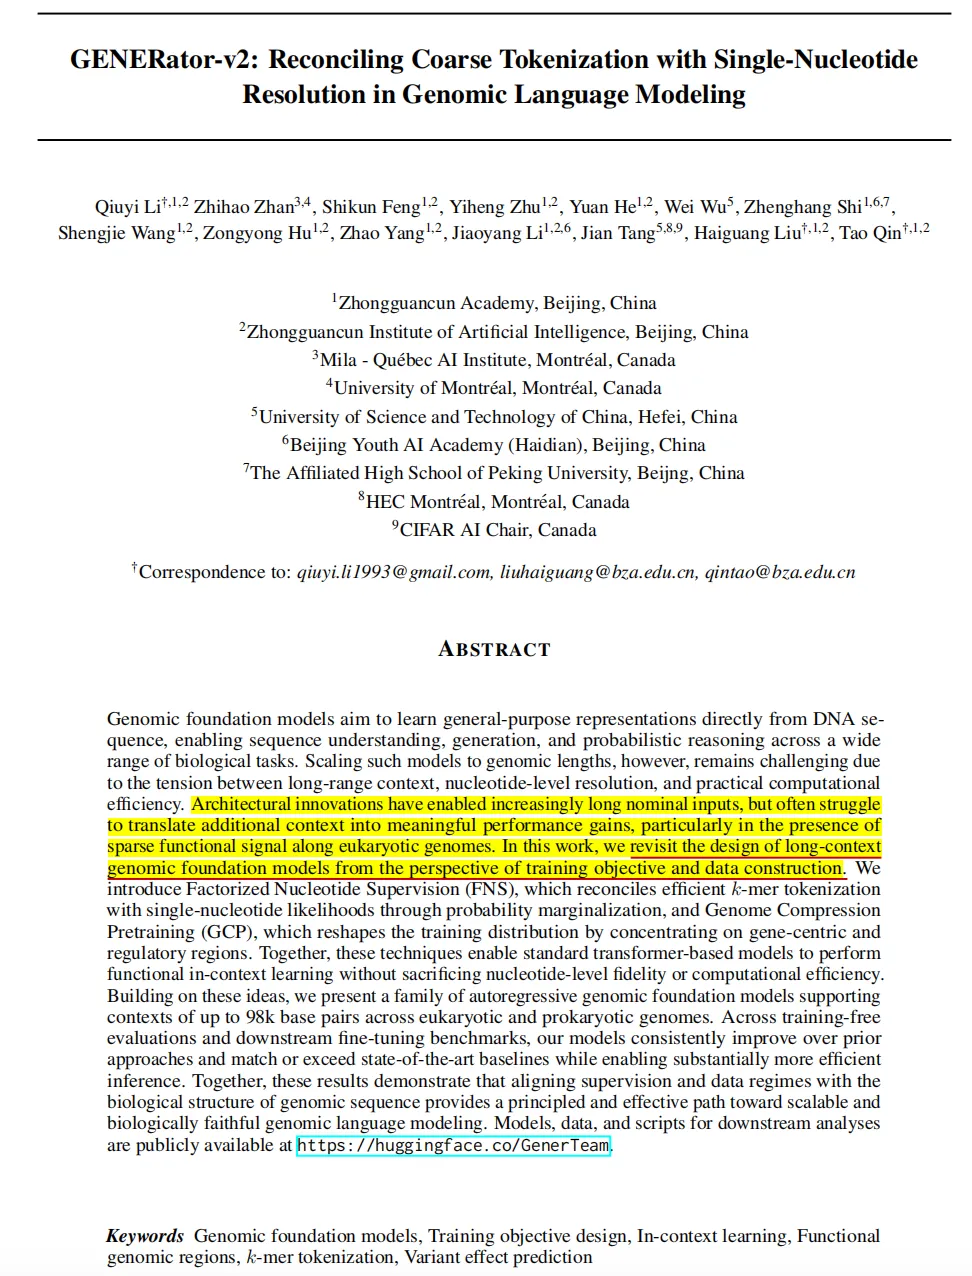
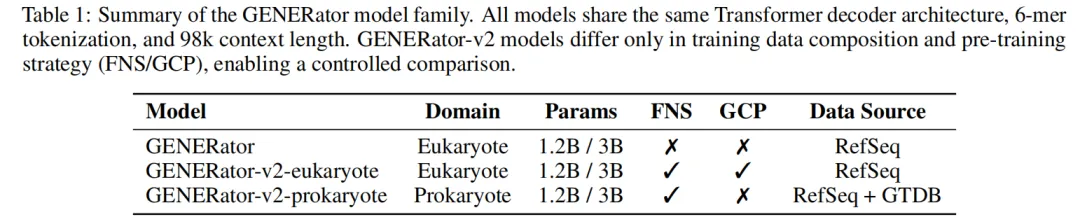
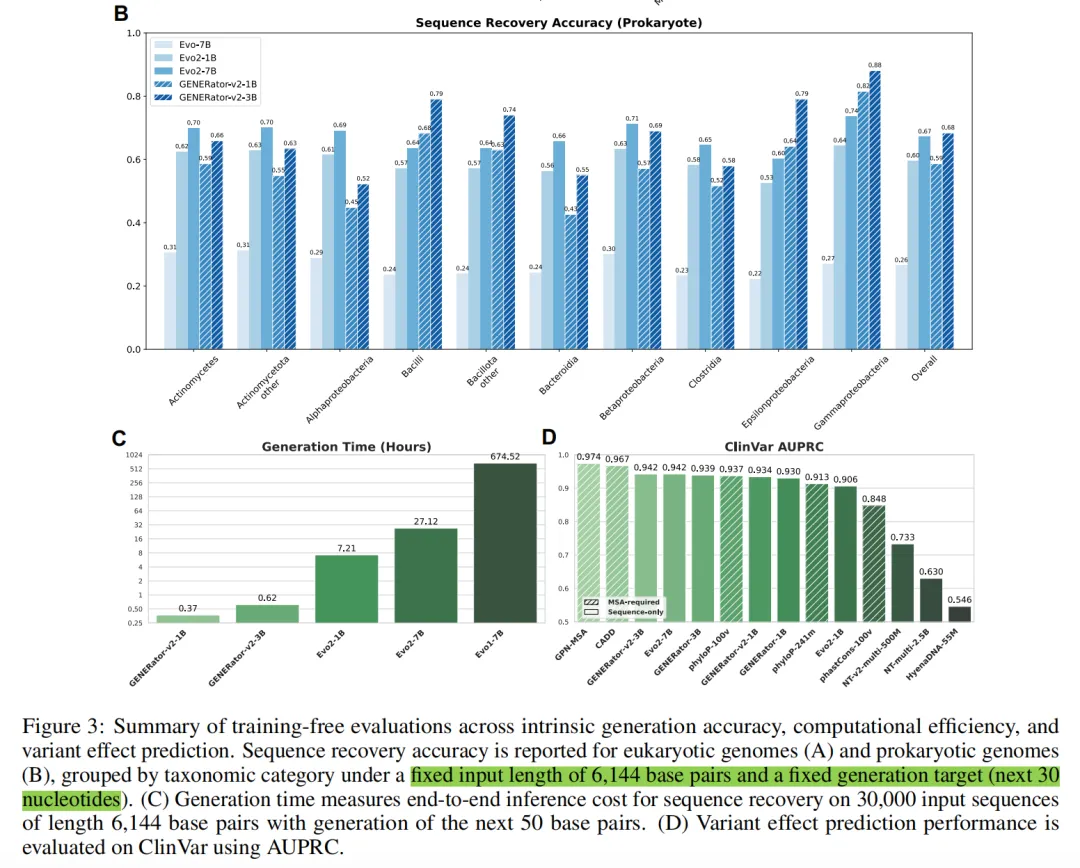
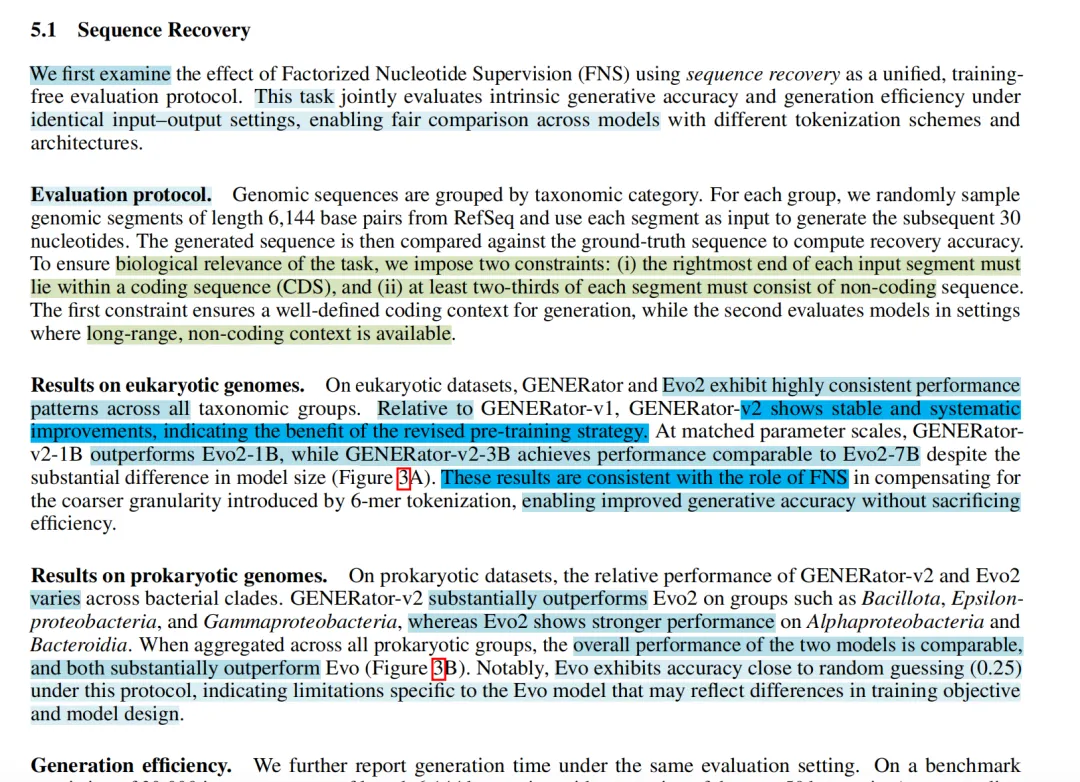
(GENERator 的名字容易让人产生一种其已经验证了基因组级别长程生成能力的印象;实际上作为它最主要的 generative benchmark 的 sequence recovery 任务,horizon 原来只有 30 bp。OvO)
(顺便:虽然目前只是一篇未经 peer review 的 preprint,仍然从写作上(rebuttal 和之前梳理实验结果时每次都被老师批评orz)学习一下成熟工作如何叙述实验设计和不啰嗦的实验结论(...看起来客观地夸一夸自己;同时不要踩其他团队的现有 sota):)
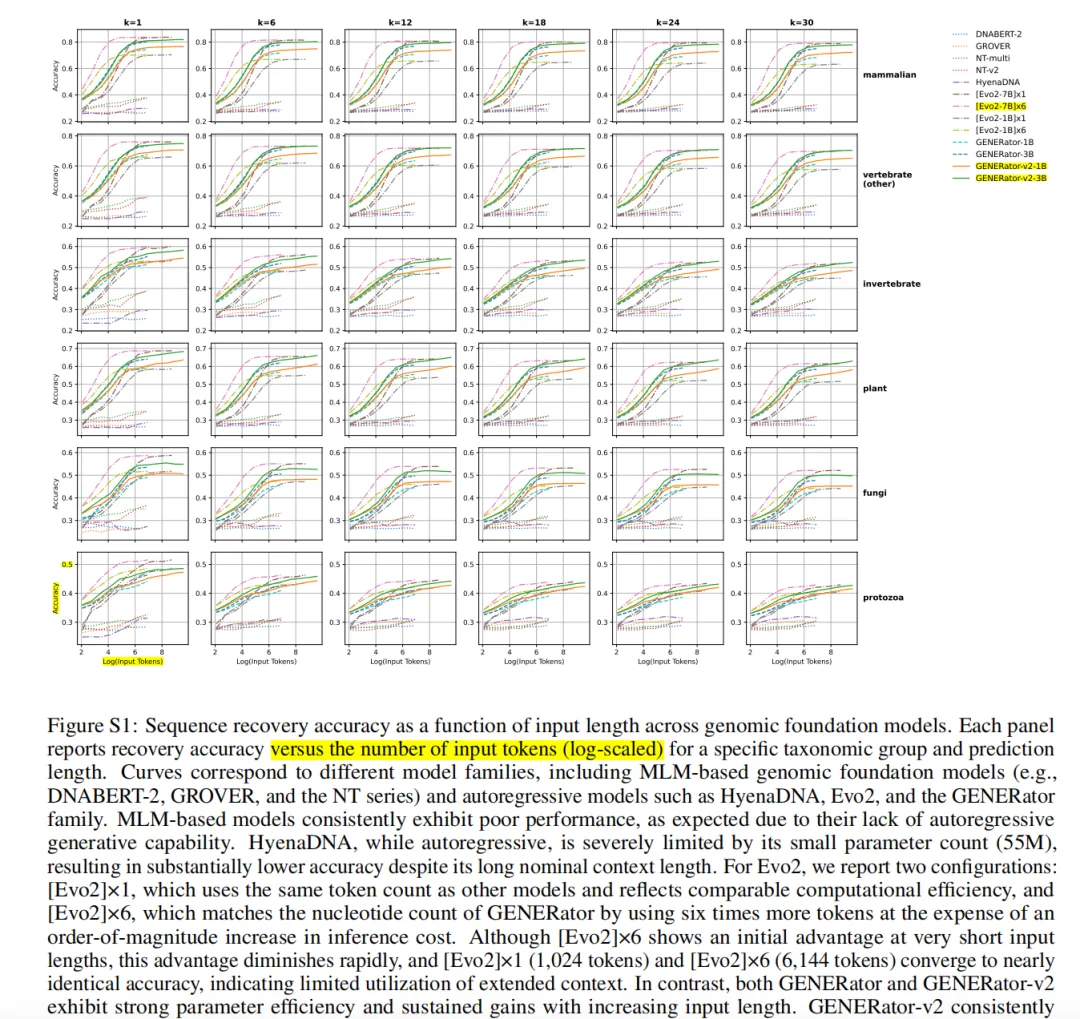
然后(更加 technical / 显得客观地)继续夸:(虽然但是,原来 Evo 的表现是这样的吗... 也专门去 appendix 扫了一下具体指标,注意看:)
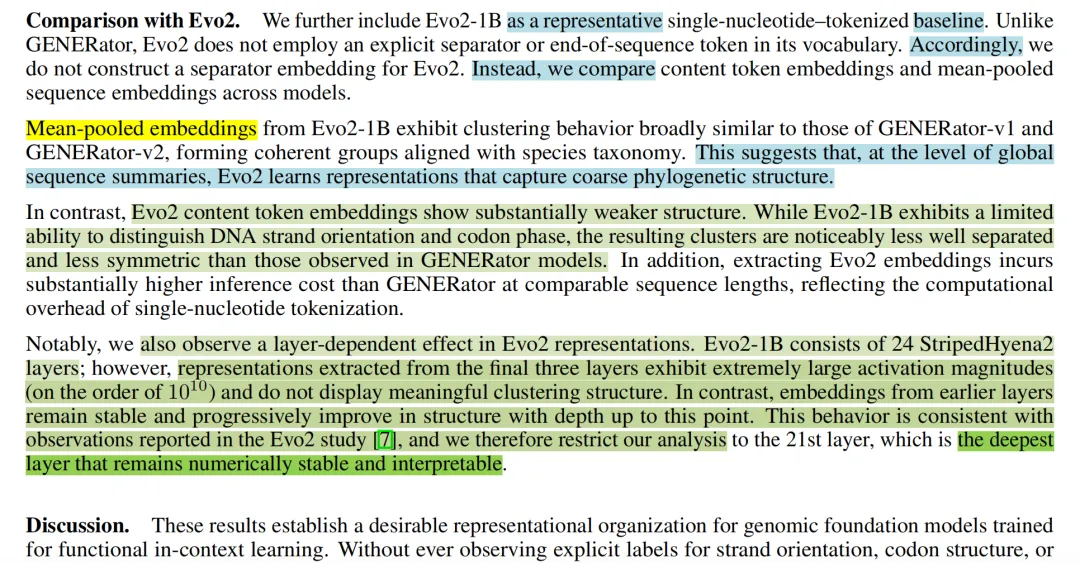
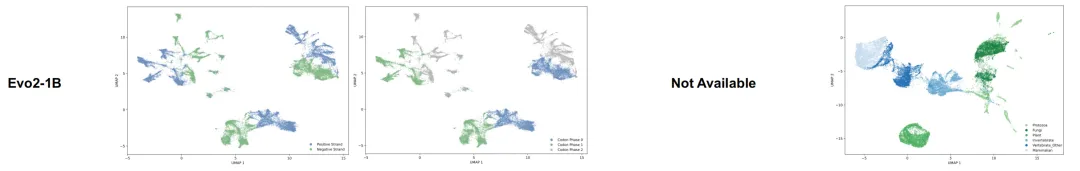
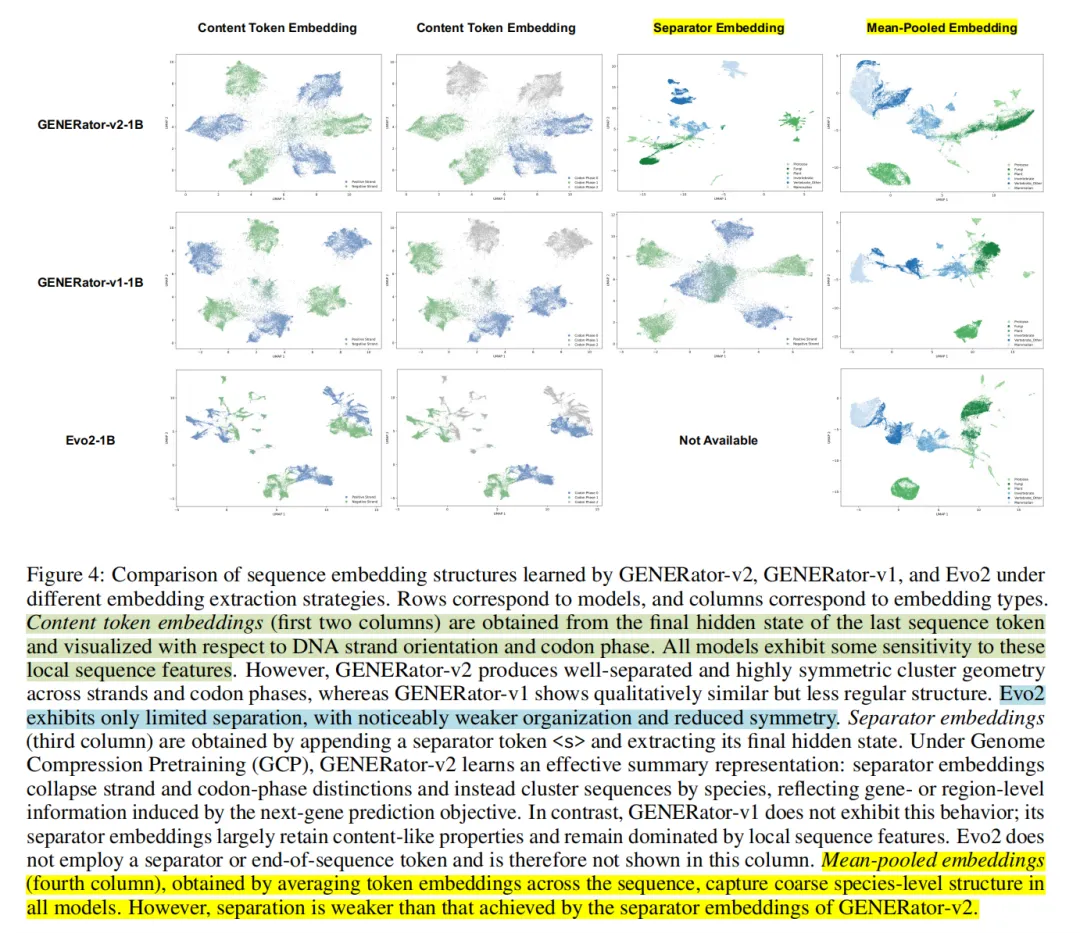
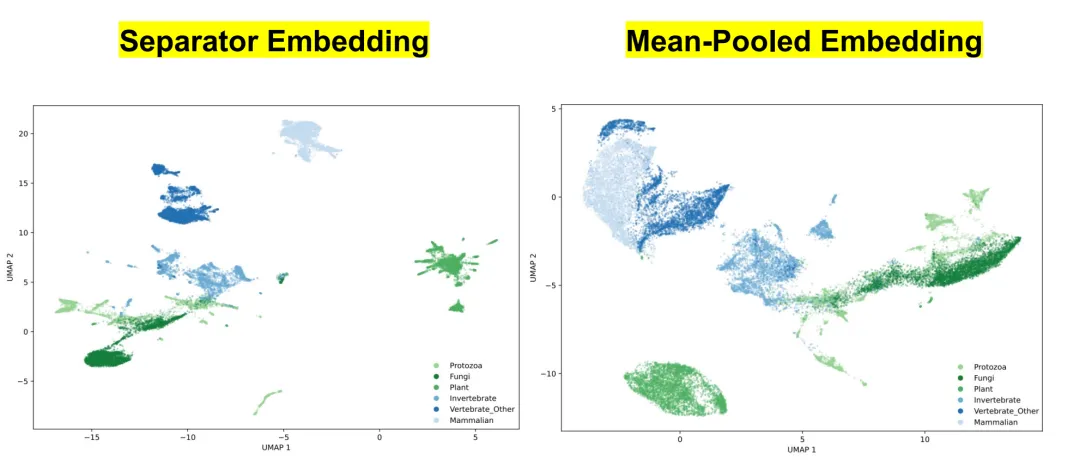
以及,最喜闻乐见的 umap 看 embeddings,
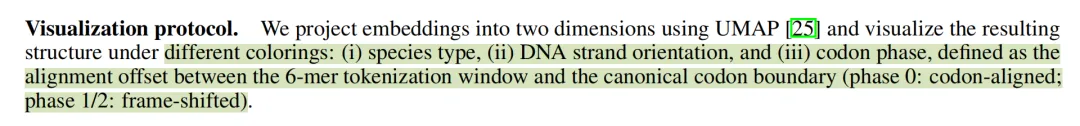
——wowwww 放大看右上角,GENERator-v2 自己的效果这么看真的好好哇 OvO!
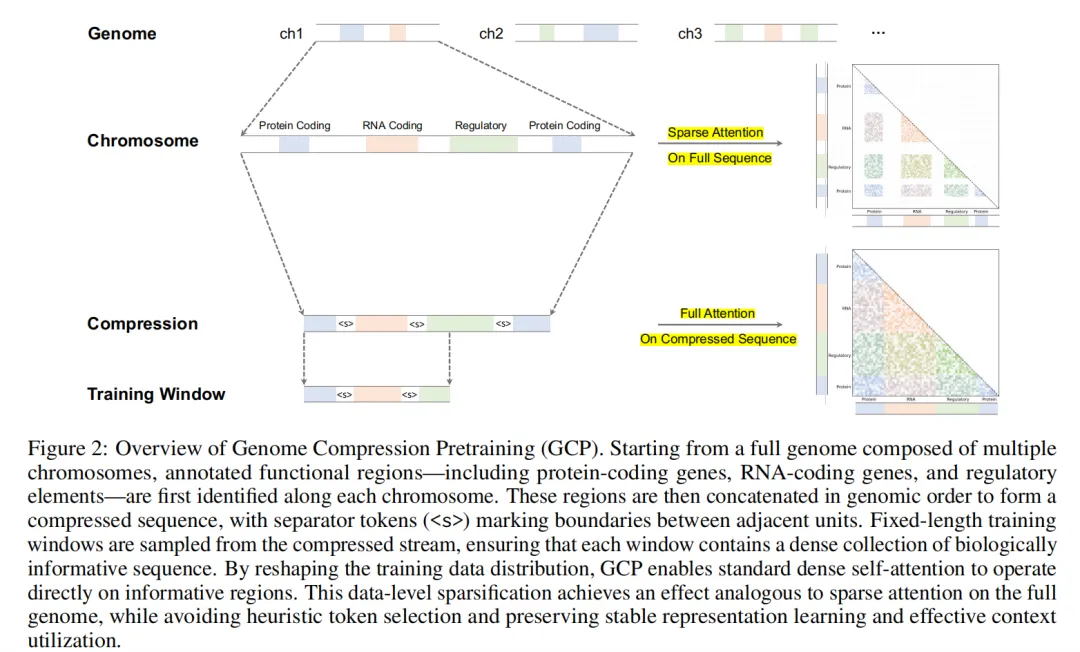
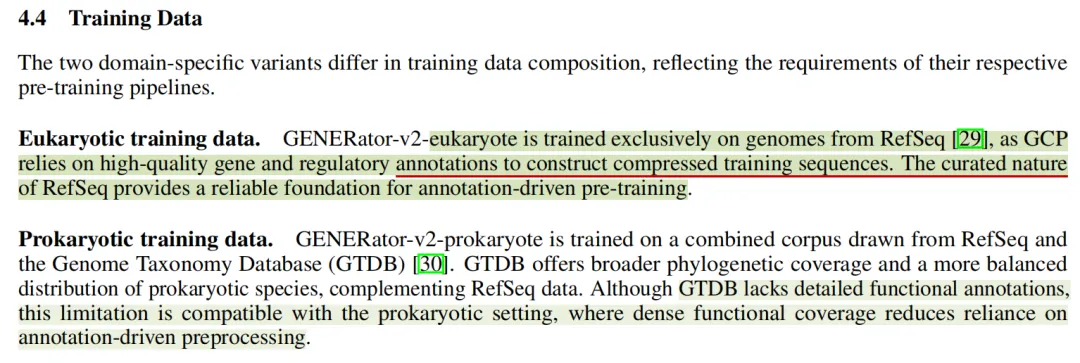
这里即谈到他们的第二个训练小巧思(GCP);跟自己的关系不怎么大,但属实是巧妙的设计:
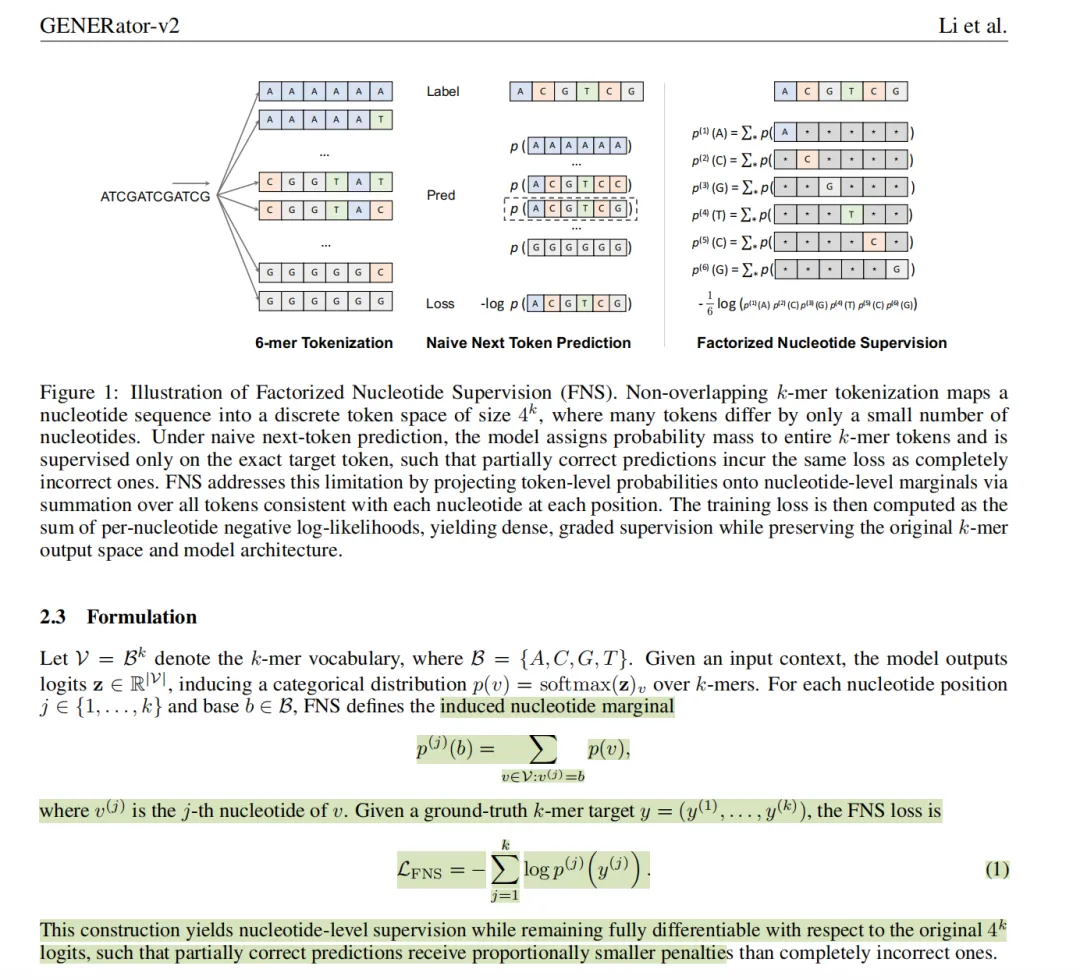
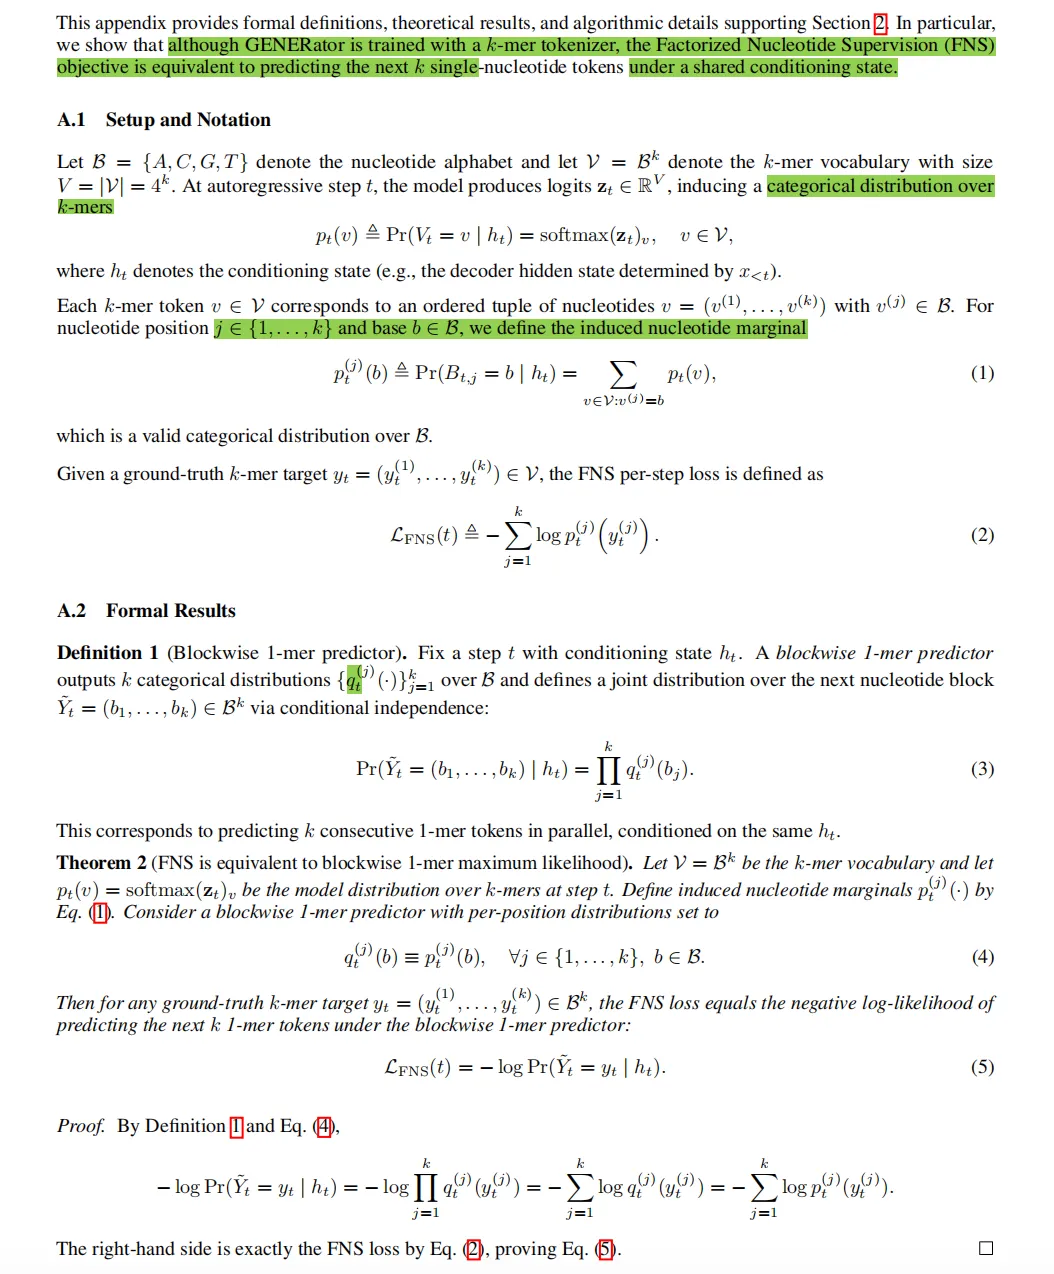
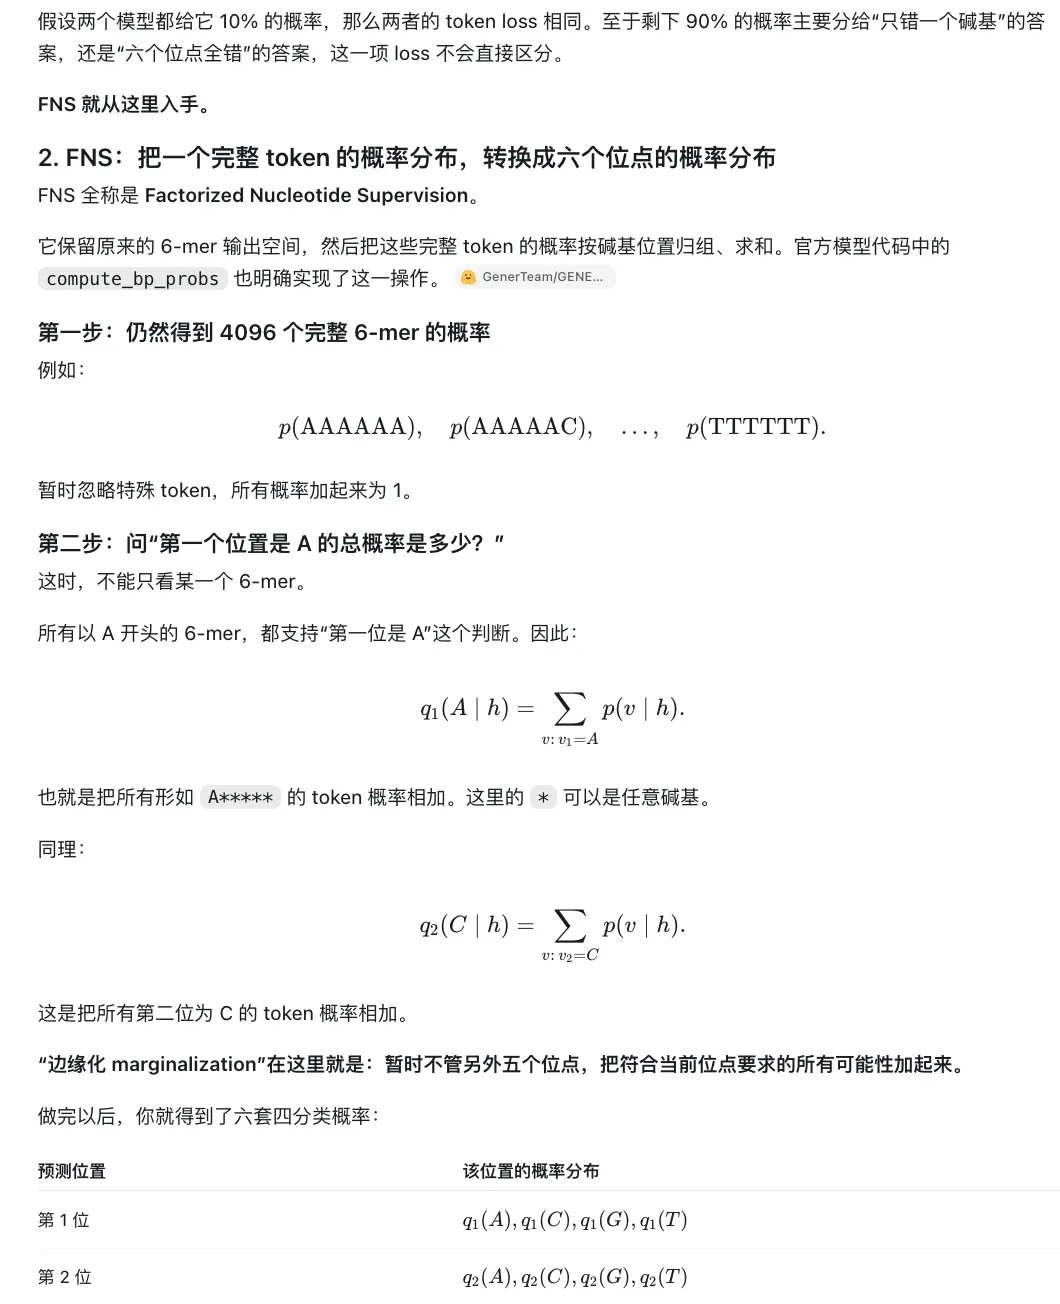
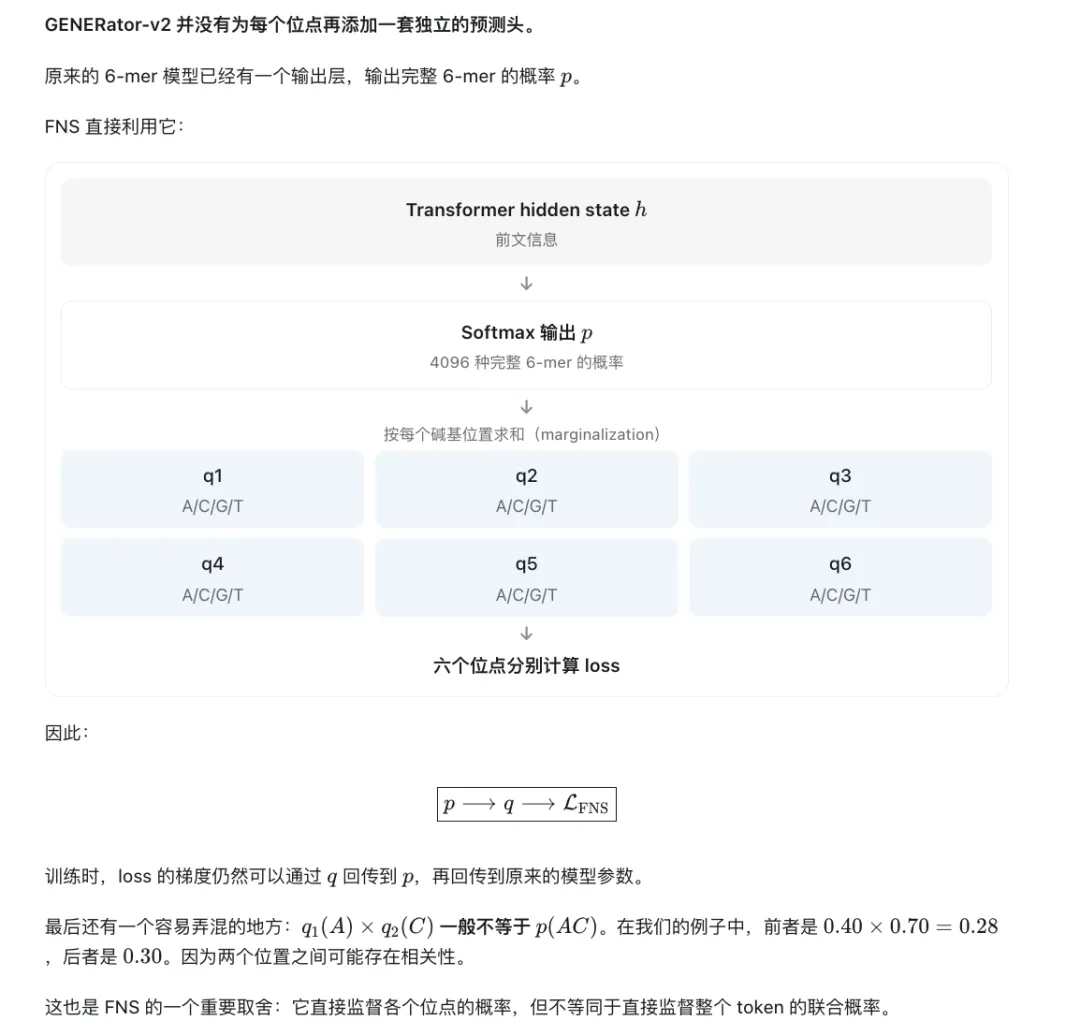
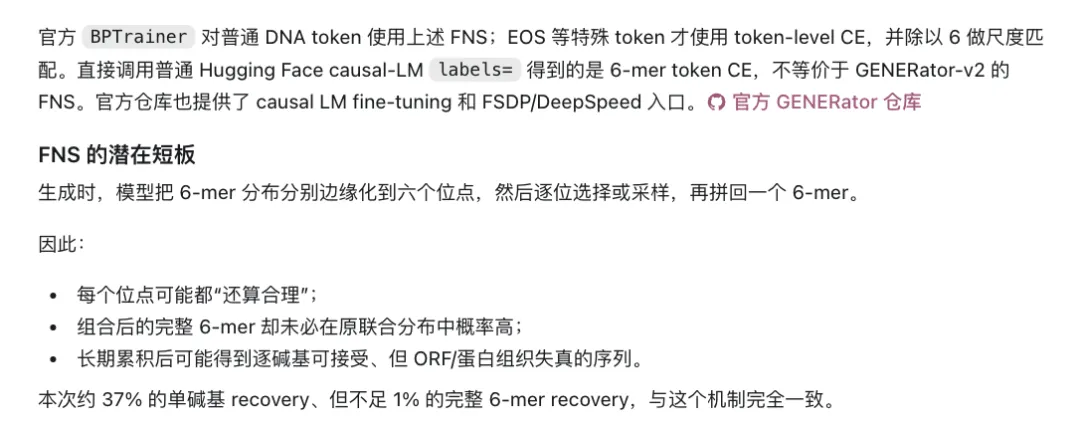
感到真正尤其有意思的就是这个所谓 Factorized Nucleotide Supervision (FNS):"FNS does not modify the model architecture, tokenizer, or output dimensionality. The model still produces 4^k logits per step; FNS operates entirely at the level of loss construction and gradient allocation. "虽然模型仍预测一个 4096-class 6-mer token,但训练巧思在于 loss 是把这个 token marginalize 成六个 nucleotide positions 然后分别做 单 nucleotide-level 的 supervision!(论文也提到之前打卡重点讲的 MTP,讲它和 MTP 在概念上有联系但方向相反:FNS 是把一个 coarse k-mer token 分解成多个 nucleotide supervision,而前者是反过来那样子预测嘛)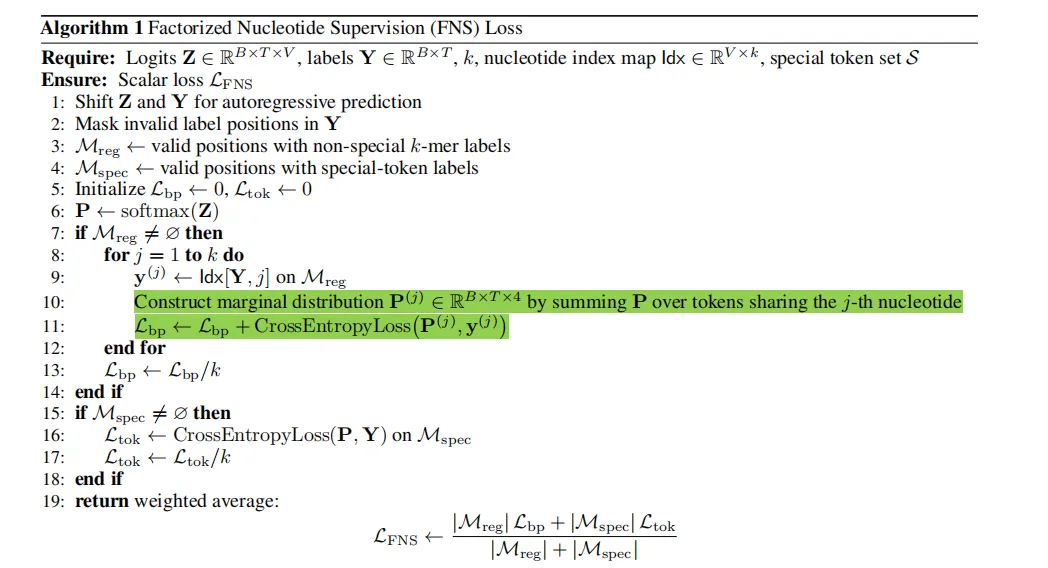
(交给 Codex 让它先跑一下这个模型试试,)这么看 trade-off 也确实有道理的:"FNS redefines k-mer language modeling as a structured, nucleotide-aware learning problem. By decomposing discrete k-mer prediction into marginal nucleotide supervision, it alleviates label sparsity, stabilizes optimization, and enables SNP-level reasoning while preserving the computational advantages of coarse tokenization."读 GENERator-v2 的训练小巧思... 在想自己毕竟不是做基模预训练的;何况即便做大规模预训练的,也都要从各种角度精心设计。自己的 CPT 还是怎么都不 work 啊 ><。
---
昨天突然莫名想到了一些东西,,,以前不信服周围一些人(比如奶奶和姐姐;或许随口一说)的所谓“天注定” / determinism,想凭某种意志去向自己证明人生是 stochastic 的是具备能挣脱既定约束的 plasticity 的。于是踩出了错误的选择吧,,?
其实本来忘掉了这些奇怪的东西,,这几个月一直做 long-horizon generation,不知怎地又回忆起来,反思,又意识到 "living" 简直就是 autoregressive generation,但当时执拗地想要做二分时还是太无知了;
既不是 deterministic 的 greedy decoding,也不是那么随机地乱采样,大概确实是在既有 context 所塑造的条件概率分布下一步步自回归进行的 probabilistic 的 sampling,就像遗传易感性并不意味着必然外显。
又想,既然应该确是 probabilistic,...每个人是有自己的 decoding 时的(或许可调的) temperature 啊。。OAO